| 속성 | 역할 | 권장 개수 |
|---|---|---|
| Research Theme | 최상위 연구 축 | 노트당 1개 |
| Domain | 구체적인 연구 분야 | 노트당 1~3개 |
| Methods | 사용하거나 다룬 기술 | 제한 없음 |
| Type | 문서 형식 | 1개 |
| Status | 작성 상태 | 1개 |
| Related Project | 연결된 프로젝트 | 0~2개 |
Paper Information
Title: Is Space-Time Attention All You Need for Video Understanding?
Authors: Gedas Bertasius, Heng Wang, Lorenzo Torresani
Affiliation: Facebook AI; Dartmouth College
arXiv ID: arXiv:2102.05095
Topic: Video Action Recognition, Video Understanding, TimeSformer, Vision Transformer, Space-Time Attention, Divided Space-Time Attention, Long-Term Video Modeling
Venue: Proceedings of the 38th International Conference on Machine Learning (ICML 2021), Proceedings of Machine Learning Research (PMLR), Vol. 139
Pages: 813–824
1. One-line Summary
TimeSformer는 ViT를 video domain으로 확장하여 spatial·temporal attention을 분리한 Divided Space-Time Attention으로 효율적인 convolution-free video recognition을 구현하고, 긴 temporal context까지 확장 가능함을 보인 모델이다.
2. Problem
Video understanding과 NLP는 고수준의 유사성을 가지고 있다
- 영상과 문장은 모두 sequential하다
- 단어의 뜻은 문장 내의 다른 단어들과의 관계성에 의해 이해되듯이 shorterm segment 속 원자적인 움직임은 완전히 명확하게 되기 위해서는 그 영상의 나머지부분과의 맥락을 알아야 한다.
→ NLP의 긴 범위의 self attention 모델은 영상 모델링에서 또한 매우 효율적일것이다라고 예상할 수 있음
BUT 영상 도메인에서 2D, 3D 합성곱은 서로 다른 영상 과제 속에서 공간적(spatial) 정보와 시간적(temporal) 정보를 함께 담은 특징을 위한 핵심 연산자로 여겨진다.
-
self-attention을 CNN의 convolutional feature 위에 추가해서 쓰는 방식은 이미 효과가 있었다
Video → CNN/3D CNN → feature map → self-attention → prediction
-
하지만 video recognition 모델을 convolution 없이 self-attention만으로 구성한 사례는 보고되지 않았다
그러므로 저자들이 합성곱 대신 self-attention을 활용해서 효율적으로 잘 작동하는 convolution free한 영상 아키텍쳐를 만들겠다라고 주장함
💡 그럼 CNN은 어떤 한계점이 있다고 저자들은 본 것인가
충분한 대규모 데이터가 있어 필요한 패턴을 데이터로부터 직접 학습할 수 있는 환경에서는 강한 귀납적인 편향 (Local connectivity, translation equivariance)가 오히려 모델의 표현력을 지나치게 제한할 수 있다.
합성곱 커널은 짧은 시공간적 정보를 포착하는데 특화된 디자인이지만 receptive field를 넘어서는 dependency에 대해서는 모델링할 수 없다.
GPU의 발전에도 불구하고 deep CNN은 비싸고 특히 고해상도의 긴 영상을 다룰때는 더 비싸다.
현재 Transformer의 self-attention의 한가지 단점은 토큰의 모든ㄴ 쌍에 대하여 유사도 측정을 진행해야한다는 점인데 TimeSFormer에서는 큰 규모의 패치를 다루나보니 비싸다
→ 그래서 저자들은 이러한 문제를 해결하기 위해 시공간 볼륨(space-time volume)에 적용할 수 있는 여러 scalable self-attention 설계를 제안하고, 이를 대규모 action classification 데이터셋에서 실험적으로 평가한다.
→ 최고는 Divided attention 구조인데 이건 temporal attention과 spatial attention을 각각 신경망 블록에 적용한것.
2.1. Related Works
2.1.1. CNN + Self-Attention
기존 이미지·비디오 연구에서는 self-attention을 convolution과 함께 사용하는 방식이 이미 존재했다.
- Non-Local Networks
- convolutional feature 위에 non-local operation을 적용
- Transformer의 self-attention과 유사한 전역적 관계 모델링을 수행
- Bello et al.
- 2D self-attention을 2D convolution의 대체재로도 사용 가능
- 하지만 convolutional feature에 self-attention feature를 추가했을 때 더 좋은 성능을 보임
- Relation Networks / DETR
- object detection에서 convolutional feature map 위에 self-attention을 적용
즉 이 계열에서는 self-attention이 완전히 독립적인 feature extractor라기보다, CNN이 추출한 feature를 보완하는 역할에 가까웠다.
2.1.2 Self-Attention as a Substitute for Convolution
TimeSformer는 위의 CNN + Attention 계열보다는, self-attention을 convolution의 대체재로 사용하는 이미지 네트워크와 더 밀접하다.
하지만 기존 연구들은 개별 pixel을 query로 사용했기 때문에 계산량과 메모리 사용량이 매우 컸다.
이를 해결하기 위해 다음과 같은 방법들이 사용되었다.
- Local Attention
- self-attention의 범위를 주변 neighborhood로 제한
- Downsampled Global Attention
- 이미지를 크게 축소한 뒤 global self-attention 수행
- Sparse Key-Value Sampling
- 모든 key/value를 사용하지 않고 일부만 선택
- Axial Attention
- 전체 2D 공간에서 attention을 한 번에 수행하지 않고
- width, height 등의 축별로 분리하여 계산
TimeSformer의 일부 attention scheme도 이러한 sparse / axial computation을 비디오의 spatiotemporal volume으로 확장한다.
2.1.3 ViT와의 직접적인 연결
TimeSformer의 효율성은 sparse/axial attention 자체보다 ViT의 patchification 방식에서 더 직접적으로 나온다.
ViT는 개별 pixel 대신 image patch를 token으로 사용한다.
Image → Patches → Linear Embeddings → Transformer
TimeSformer는 이 아이디어를 video로 확장한다.
Video → Frame-level Patches → Linear Embeddings → Space-Time Self-Attention
즉 각 frame을 patch로 분할하고, 각 patch를 linear embedding으로 변환한 뒤 Transformer의 input token으로 사용한다.
→ TimeSformer는 ViT의 patch-based Transformer 구조를 video로 확장한 모델
💡 Pixel-level 방식과 ViT의 Patch 방식의 가장 큰 차이점 Pixel-level 방식
입력의 원천은 RGB pixel 값입니다.
pixel 하나가 token 하나가 됩니다.
각 pixel token을 embedding한 뒤, pixel token끼리 attention을 계산합니다.
따라서 token 수가 H×W로 매우 많습니다.
ViT patch 방식
역시 입력의 원천은 동일한 RGB pixel 값입니다.
하지만 P×P개의 pixel을 묶어 하나의 patch token으로 만듭니다.
따라서 token 수가 로 크게 감소합니다.
이후 attention은 pixel끼리가 아니라 patch token끼리 계산합니다
Pixel-level self-attention과 ViT 모두 근본적으로는 pixel 값을 입력으로 사용하지만, pixel-level 방식은 각 pixel을 하나의 token으로 만들어 pixel token들 사이의 attention을 계산하는 반면,
2.1.4 기존 Video Transformer 연구
TimeSformer 이전에도 Transformer는 video 분야에서 사용되고 있었다.
- Video generation
- Action localization / recognition
- Video classification
- Group activity recognition
- Video captioning
- Video question answering
- Video-grounded dialogue
- Multimodal video-text pretraining
하지만 대부분의 경우 구조는 다음과 같았다.
Video → CNN → Convolutional Feature Map → Transformer
즉 Transformer를 사용하더라도 CNN이 여전히 video feature extractor 역할을 수행했다.
2.1.5 TimeSformer의 Positioning
저자들이 강조하는 차별점은 당시까지 self-attention을 video recognition의 exclusive building block으로 사용하는 구조가 없었다는 점이다.
기존:
Video → CNN → Feature → Transformer → Prediction
TimeSformer:
Video → Frame-level Patches → Self-Attention → Prediction
따라서 TimeSformer는
- convolution 없이 frame-level patch를 token으로 사용하고
- space-time self-attention으로 video recognition을 수행하는
convolution-free video architecture를 제안한다.
기존 연구가 CNN에 attention을 추가하거나 이미지에서 convolution을 self-attention으로 대체하는 단계였다면, TimeSformer는 ViT의 patch 기반 구조를 video로 확장하여 CNN 없이 space-time self-attention만으로 video recognition을 수행하려는 접근이다.
3. Method
3.1. Model
Input
The TimeSformer takes as input a clip
- $F$ RGB frames
- size $H\times W$ sampled from the original video
Decomposition into patches
각 프레임을 N개의 겹침 없는 P × P 패치들로 쪼갠다. (non-overlapping patches)
> $N = HW/P^2 <-> P = \sqrt{\frac{HW}{N}}$Linear Embedding
각각의 패치들을 학습 가능한 행렬, 를 이용하여 라는 임베딩 벡터로 **선형 변환(linearly map)**한다
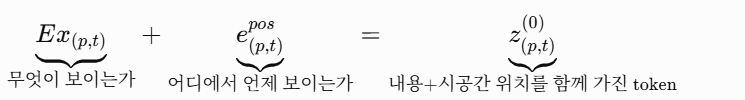
- $e^{\text{pos}}_{(p,t)}$ : 그 patch가 비디오에서 **어디에 있고 언제 등장하는지(position in space and time)** 를 알려주는 embedding
- $E\bold x_{(p,t)}$: patch의 **내용(content)**을 표현하는 embedding
- $p = 1, . . . , N , \;\;and\;\; t = 1, . . . , F$
💡 Positional Embedding을 왜 더하는가?
Positional embedding을 더하는 목적은 나중에 위치 벡터를 다시 분리해서 복원하기 위함이 아니다. 같은 시각적 내용을 가진 patch라도 위치가 다르면
가 되므로 Transformer가 서로 다른 token으로 처리할 수 있게 한다.
왜 단순히 더해도 되는가?
이후 Transformer에서를 계산하는데,이므로 가 된다.
따라서 attention 계산에는 자연스럽게 내용 정보와 위치 정보가 함께 반영된다.
주의할 점
Positional embedding을 더한 뒤 원래 x와 p를 다시 분리하려는 구조가 아니다.
위치는 벡터의 원점으로부터 거리로 표현되는 것이 아니다.
각 위치마다 서로 다른 D차원 벡터 패턴이 학습된다.
더하기를 사용하면 embedding dimension을 D로 유지하면서 content와 position 정보를 결합할 수 있다.
한 줄 요약
Positional embedding을 더한다는 것은 위치 정보를 따로 저장하는 것이 아니라, patch representation 자체를 위치에 따라 다르게 만들어 이후 attention이 위치와 시간을 함께 고려하도록 하는 것이다.
Query-Key-Value computation
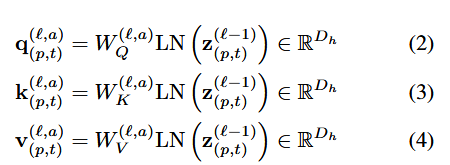
Denotation 정보
- : attention head의 총 개수
- : 여러개의 attention head의 인덱스
- : 각각의 attention head의 latent dimensionality
**multi-head attention에서 여러 head의 출력을 다시 합쳤을 때 전체 embedding 차원 D를 그대로 유지하려고** 보통 각 head 차원을 $D_h=D/A$
💡 Multi head attention의 계산 흐름 예를 들어 A=12개의 head가 있으면, 같은 입력 token representation 에 대해 각 head가 자기만의 projection matrix를 사용해서 동시에 등을 계산한다.
같은 입력 z
   ├─ Head 1 → Q1, K1, V1 → Attention 1
   ├─ Head 2 → Q2, K2, V2 → Attention 2
   ├─ Head 3 → Q3, K3, V3 → Attention 3
   ...
   └─ Head A → QA, KA, VA → Attention A
이 head들은 서로 독립적인 파라미터를 사용해 병렬로 서로 다른 관계를 학습한다.
그리고 각 head의 결과 를 마지막에 concatenate해서 로 합친다.
💡 Multi head attention의 head 별 차이 발생의 원인 각 attention head 는 서로 다른 학습 가능한 projection matrix를 가진다.
따라서 같은 입력 를 사용하더라도 각 head는 서로 다른 Q, K, V를 생성한다.
왜 서로 다른 관계를 학습할 수 있는가?
각 head의는 서로 독립적인 parameter
학습 시작 시 일반적으로 서로 다른 random initialization을 가짐
따라서 같은 입력이라도 head마다 처음부터 다른 Q/K/V representation이 생성됨
이후 각 head가 만든 attention 결과가 다르므로 loss에 대한 gradient도 서로 다르게 전달될 수 있음
결과적으로 각 head의 parameter가 서로 다른 방향으로 학습될 수 있음
흐름으로 보면:
하지만 각 head가 반드시 서로 다른 의미나 기능을 학습하는 것은 아니다.
Multi-head attention은
Head 1 = motion
Head 2 = object
Head 3 = background
처럼 역할을 미리 지정하지 않는다.
대신 각 head에 독립적인 parameter와 서로 다른 학습 경로를 제공하여 다양한 관계를 학습할 수 있는 가능성을 만든다.
따라서 서로 다른 head가 비슷한 attention pattern을 학습하는 경우도 가능하다.
-
:이전 Transformer block이 만든 patch representation
e.g. first block : patch pixel→patch embedding + position
-
: 먼저 Layer Norm을 적용한다. (Pre-LN 구조)
이전 block의 patch representation ↓ LayerNorm ↓ 정규화된 representation
-
같은 patch representation에서 Q, K, V를 각각 만든다 (2, 3, 4)
- Query: 나는 어떤 정보를 찾고 있는가?
- Key: 나는 어떤 특징을 가지고 있는가?
- Value: 실제로 전달할 정보는 무엇인가?
Self-attention Computation
Source: Original Document
Joint Attention 기반 설명
로 query patch 에 대한 self-attention weight 를 설정한다고 가정할 아래와 같이 점곱을 활용해서 구할 수 있다. 은 softmax 활성화 함수를 의미한다
주의깊게 볼 점은 attention 계산을 한번에 한 차원(e.g. Spatial Only or Temporal Only)으로 하면 계산량이 줄어든다고 한다. (의 query-key comparison 생성)
- 한번에 모든 차원에 대해 계산을 하는 경우 → e.g. Joint Space-Time Attention, …,
- 각각의 차원에 대해 계산을 하는 경우 → e.g. Divided Space-Time Attention,…
기존의 attention 수식
기존 Transformer TimeSformer token (i) patch token ((p,t)) token (j) patch token ((p’,t’)) () () () () softmax 결과 () 다음 식에서 의 weighted sum
Encoding
self-attention weight를 구한 뒤, 실제로 각 head의 정보를 어떻게 모아서 다음 block의 representation 를 만드는가?
- 특정 query patch 에 대해 모든 value vector의 weighted sum
> $\text{output of head }a\sum\text{attention weight}\times\text{value}$
> 이때 weight 값이 앞서 앞에서 구한 $\bold\alpha$이다.
- 즉 $s^{(\ell,a)}_{(p,t)}$는 **head** $a$**가 여러 patch에서 필요한 정보를 골라 모은 결과**
- 여기서 첫 항$\alpha_{(p,t),(0,0)}v_{(0,0)}$는 **classification token의 value를 따로 포함**한 것입니다.- multi-head attention 결과를 합친다.
각 head에서가 나왔으니, 이걸 concatenate한다.
각 head가 차원이고 이므로 concatenate 후 전체 차원은 다시 가 된다.
-
output projection 를 적용하고, 원래 입력 를 residual connection으로 더한다.
-
Attention Computation 이후 MLP를 한 번 더 통과 (Transformer의 일반적인 구조)
그리고 이 가 다음 Transformer block의 입력이 된다
Classification Embedding
마지막 clip embedding은 마지막 블록의 classification token으로부터 진행된다.
→이 임베딩이 끝난뒤 video class에 대한 예측에 사용되는 1개의 얇은 hidden layer MLP을 더 얹는다.
→LN→y→MLP→class prediction
4. Key Idea
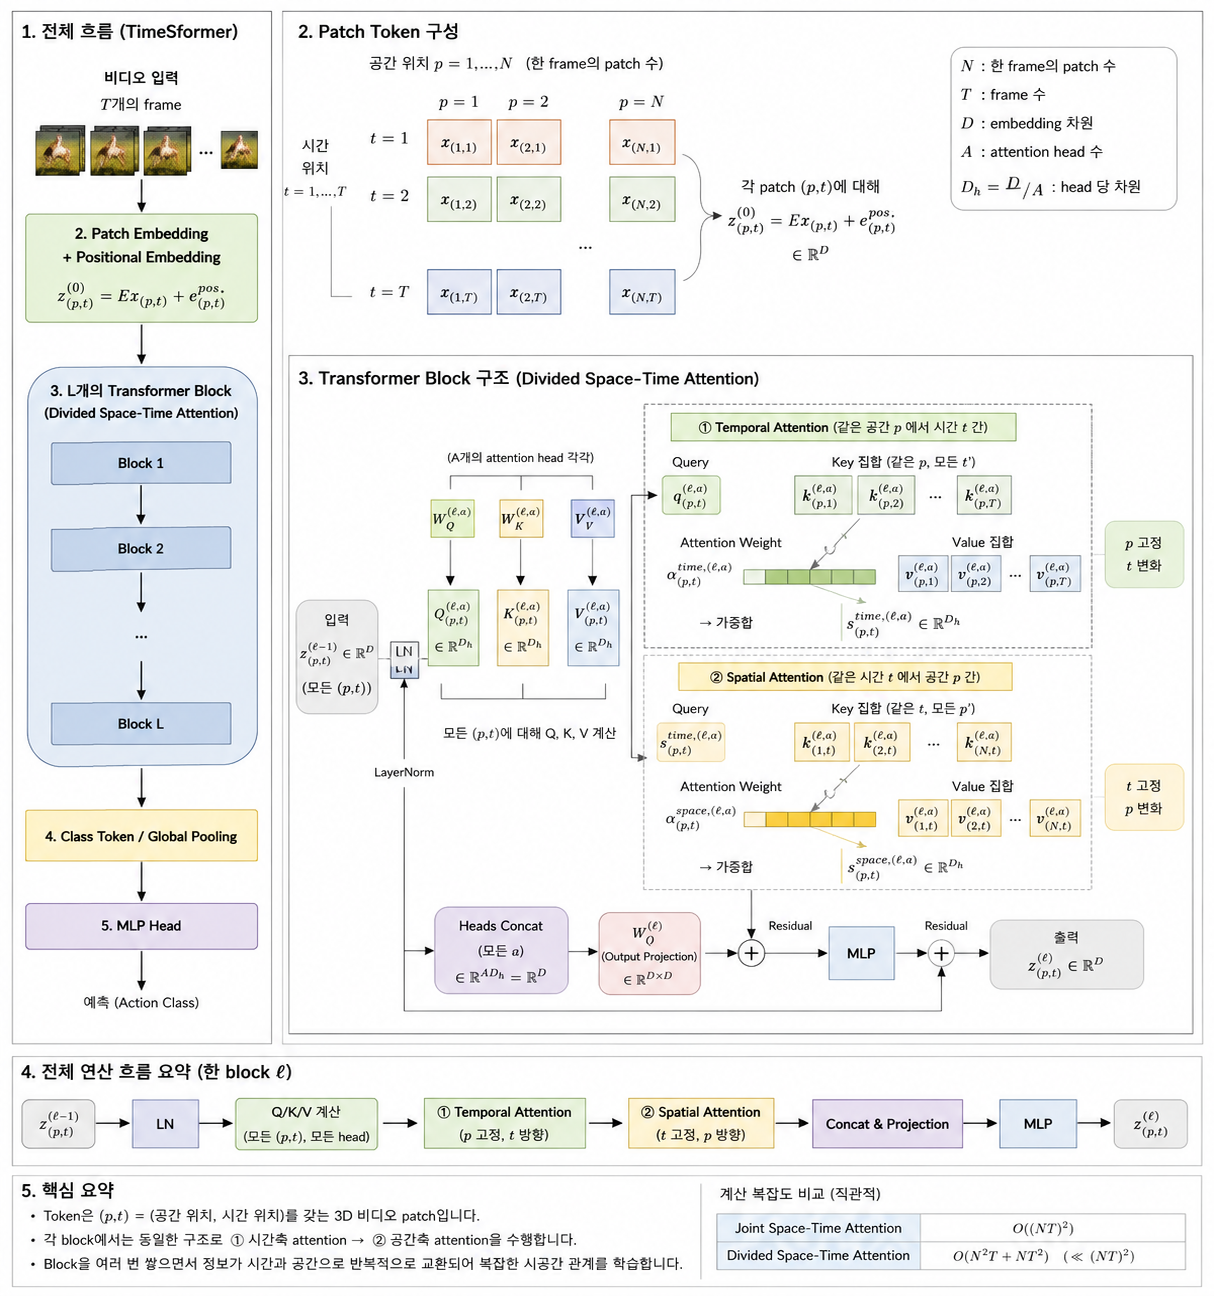
Divided Attention, where temporal attention and spatial attention are separately applied within each block, leads to the best video classification accuracy among the design choices considered.
ViT에서 영감을 받아 image space에서 space-time 3D volume으로 self-attention mechanism을 확장하여 적용한다.
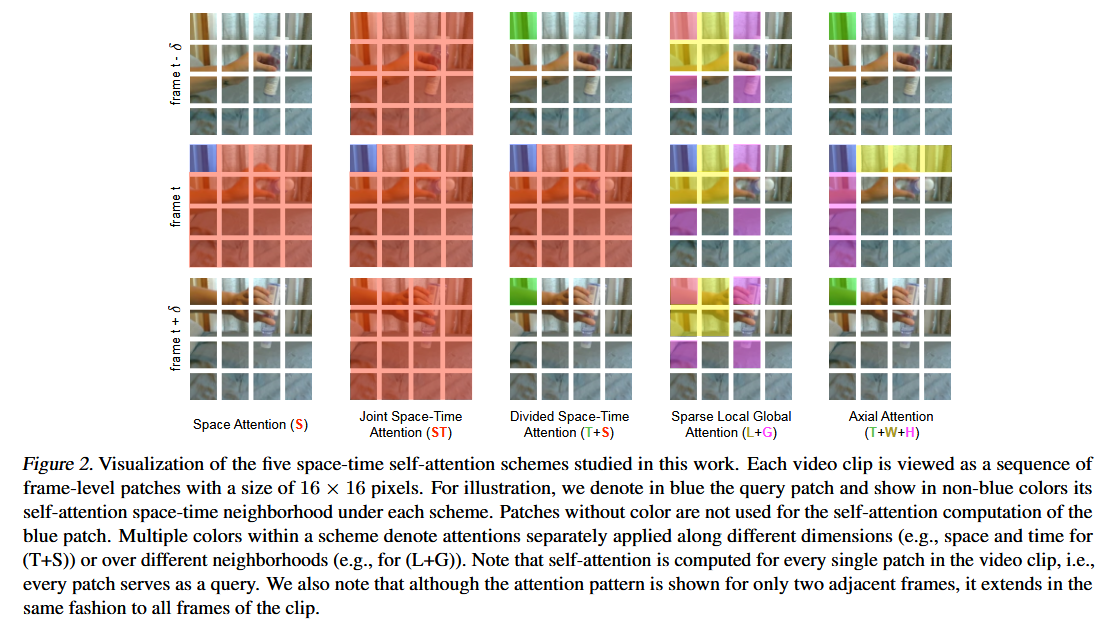
4.1. Divided Attention Strategy
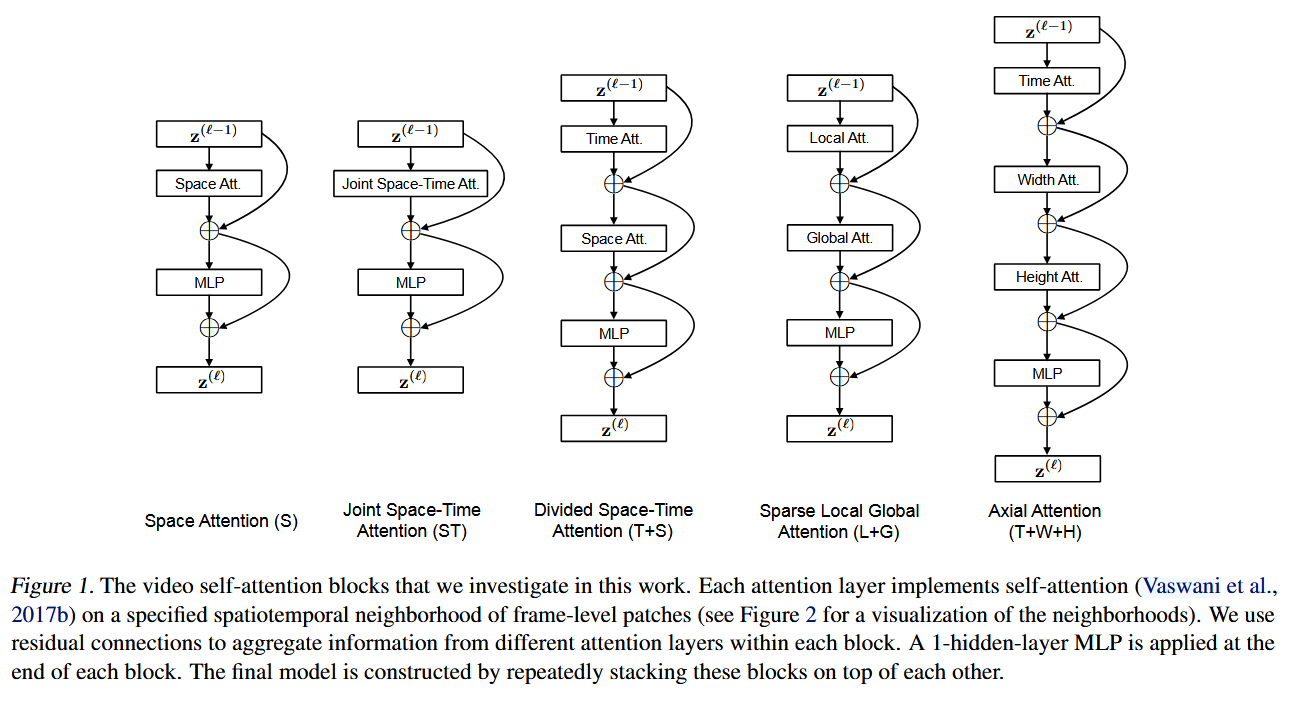
Source: Original Document
기존의 Attention에 어떻게 Temporal Information과 Spatial Information을 동시에 담을 수 있는가?
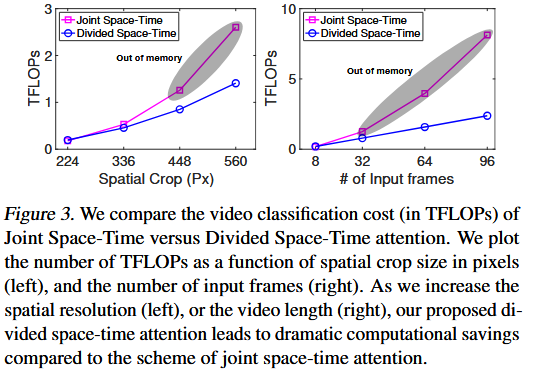
→ 원론적으로는 동시에 계산하는게 가장 성능이 잘 나올 것 같지만 temporal 따로, Space 따로 계산하는게 비용적으로도 효율적이고 성능적으로도 잘 나온다.
- Joint의 경우 patch 하나가 $NF+1$ 개 정도를 비교
- Divided Attention은 Temporal 단계: $F+1$, Spatial 단계: $N+1$ 그래서 합쳐서 대략 $N+F+2$
→ Divided Space-Time Attention (T+S) 제시
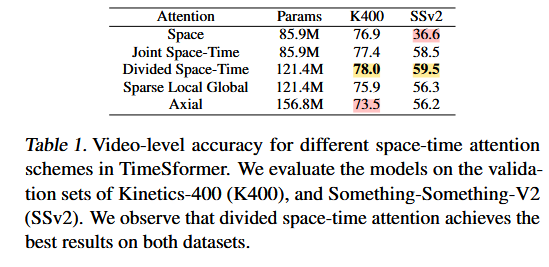
저자는 Space only attention, Joint Space-Time attention, Divided Space-Time Attention 등 5개의 attention 전략을 classification accuracy를 통해 평가했다.
Source: Original Document
-
**Sparse Local Global Attention (L+G)**은 먼저 주변의 local patch를 attention하고, 이후 전체 clip에서 stride 2로 일부 patch만 골라 sparse global attention을 합니다. 즉 full attention을 근사하는 방식
-
**Axial Attention (T+W+H)**은 attention을 Time→Width→Height의 세 축으로 더 잘게 분해
→ 어떤 방식으로 관계를 탐색할지를 구조적으로 제한하는 inductive bias. 이 경우는 효과가 없었다.
Joint → Divided → Axial로 갈수록 attention의 자유도가 줄고 구조적 bias가 강해진다 Full space-time attention으로 모든 patch를 한꺼번에 비교하는 대신, 시간축과 공간축 attention을 순차적으로 factorize하여 계산량을 크게 줄이면서도 효과적인 spatiotemporal representation을 학습할 수 있음을 보였다.
K400: spatial/appearance cue의 영향이 상대적으로 큰 action recognition benchmark
SSv2: temporal ordering, motion, object interaction 변화가 중요한 temporally-heavy benchmark
→ 따라서 두 데이터셋을 함께 비교하면 attention 구조가 단순 spatial appearance에 의존하는지, 실제 temporal dependency까지 잘 모델링하는지를 확인할 수 있다.
5. Result
TimeSformer는 temporal attention을 통해 시간 정보를 분명히 학습하지만, 모든 temporally-heavy task에서 최고의 temporal modeling을 보인 것은 아니다. 특히 SSv2에서는 explicit/inductive motion modeling을 가진 기존 video architecture보다 성능이 낮았다. Kinetics-400, Kinetics-600, Somthing-SomethingV2, Diving-48 Dataset에 대해 학습 및 평가를 진행했다.
5.0. Default Experimental Setup
- Input clip size:
- 8 frames
- 각 frame 크기:
- Frame sampling rate:
- 원본 영상에서 32 frame 간격으로 1 frame씩 샘플링
- Patch size:
- 한 frame당 이므로 patches 8 frames 기준 총 patch token 수:
Inference
- 별도 언급이 없으면 영상의 중앙 temporal clip 1개를 사용
- 해당 clip에서 3개의 spatial crop 사용
- top-left
- center
- bottom-right
예를 들어 한 temporal clip의 각 frame이 더 큰 해상도라고 하면, 그중에서 모델 입력 크기인 224×224 영역을
- 왼쪽 위(top-left)
- 중앙(center)
- 오른쪽 아래(bottom-right)

이렇게 3곳에서 잘라낸 뒤, 각 crop은 같은 시간 구간의 8개 frame에 대해 동일한 위치를 사용한다
-
각 crop의 prediction score를 평균하여 최종 예측
5.1. Analysis of Self-Attention Schemes
Source: Original Document
Out of memory표시는 Joint Space-Time Attention이 해당 설정에서는 GPU 메모리에 올라가지 못해 실제 연산을 수행할 수 없었다→ 입력 해상도나 영상 길이가 커지면 Joint Space-Time Attention은 아예 실행 자체가 불가능해질 수 있지만, Divided Attention은 계속 계산 가능하다
5.2. Comparison to 3D CNNs
비교 모델
-
SlowFast : 영상 분류에서 SOTA
CNN 기반 explicit temporal design vs Transformer 기반 space-time attention
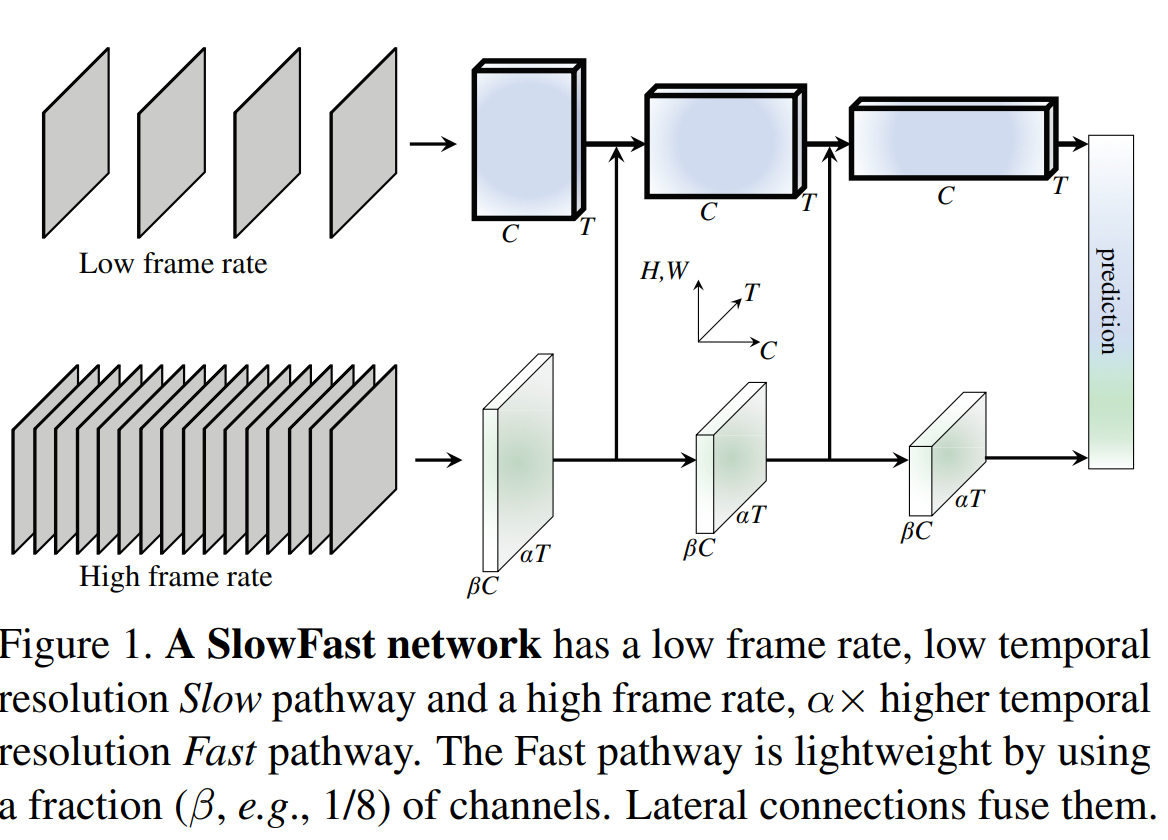
Source: Feichtenhofer et al., “SlowFast Networks for Video Recognition,” ICCV 2019, Fig. 1.
- Slow pathway
- frame을 드문드문 샘플링
- 비교적 낮은 temporal resolution
- 대신 channel 수가 많아서 appearance, semantic information을 잘 학습
- Fast pathway
- frame을 더 촘촘하게 샘플링
- 높은 temporal resolution
- channel 수는 적게 두어 계산량을 줄이면서 motion, 빠른 시간적 변화를 학습
- Slow pathway
-
I3D : 이미지 기반 사전학습을 잘 활용하는 CNN 모델
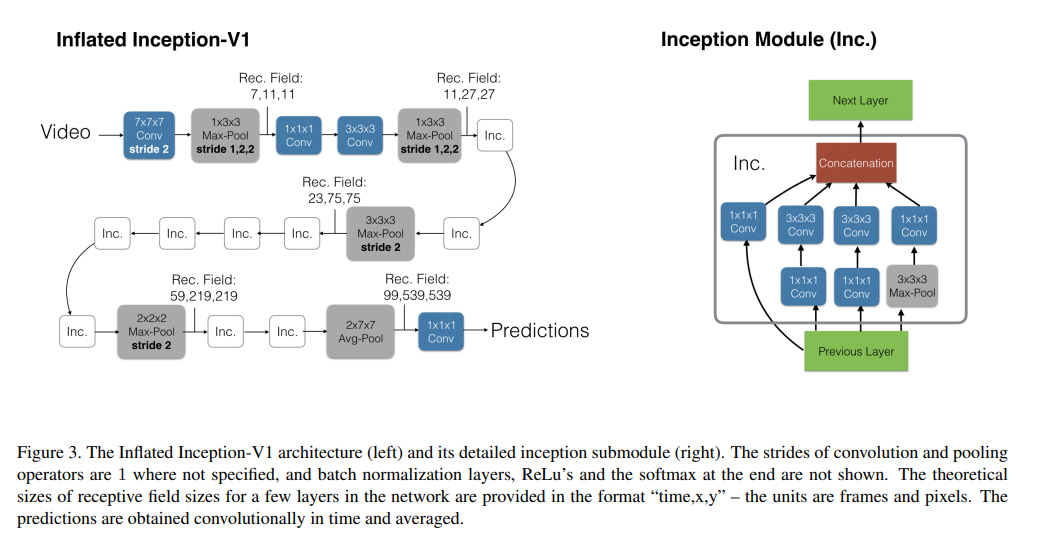
Source: Carreira & Zisserman, “Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset,” CVPR 2017.
기존의 2D CNN filter를 시간축까지 확장해서 3D convolution으로 만든 것
- **ImageNet에서 학습한 2D CNN weight를 3D convolution으로 확장해서 초기화할 수 있다**
**SlowFast:** 느린 pathway에서 **appearance/semantic 정보**를, 빠른 pathway에서 **motion 정보**를 학습하는 two-pathway 3D CNN. 당시 강력한 video classification baseline.


**I3D:** 2D convolution을 시간축까지 확장한 3D ConvNet. I**mageNet pretrained 2D weight를 활용**할 수 있어 TimeSformer와 같이 image-based pretraining의 이점을 받는 비교군.


→ 두 모델은 각각 **강력한 CNN-based temporal modeling**과 **image-pretrained 3D CNN**을 대표하는 baseline이다.
5.2.1. Model Capacity
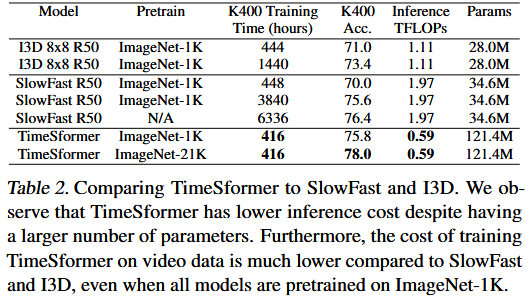
Source: Original Document
다른 모델과 비교한 결과, TimeSformer가 learning capacity, 파라미터의 수가 121.4M개로 가장 많은 모습을 보여줌에도 불구하고 추론하는데 있어 드는 비용 (0.59 TFLOPs)은 가장 적었다.
💡 TFLOPs 란 무엇인가?
1 TFLOP=1012 floating point operations
한 번의 추론을 수행하는 데 대략 얼마나 많은 계산이 필요한지를 나타내는 지표
- 반대로 SlowFast 8x8 R50의 경우 가장 작은 capacity (34.6M)를 가지고 있음에도 추론 비용은 가장 컸다. (1.97 TFLOPs)
⇒ TimeSformer가 대규모의 학습에 있어 더 적합하다.
5.2.2. Video Training Time
ImageNet으로 사전학습을 할때의 장점 중 하나는 TimeSformer가 영상 데이터에 대해 효율적으로 학습하게 한다는 점이다. 이에 반면 SOTA인 3 CNN의 경우 이미지 데이터셋에 사전학습을 했음에도 더 비싸다는 점이 눈에 띈다.
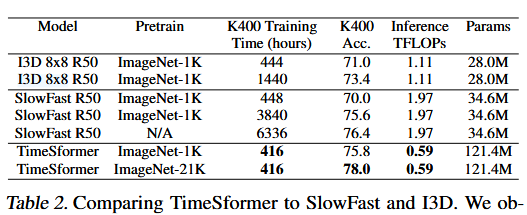
실제로 방금의 표에서 K400 Training Time (hours)를 보면 SlowFast 8 × 8 R50의 경우 K400에 대해 75.6%의 정확도에 도달하기 위해서는 3,840 Tesla V100 GPU 시간이 필요했다. 마찬가지로 I3D의 경우 1,440 Tesla V100 GPU 시간을 들여 73.4%의 정확도에 도달했다.
> 💡 Tesla V100 GPU hours가 무슨 말인가
> > NVIDIA Tesla V100 GPU를 기준으로 측정한 총 학습 계산 시간.
>
> $GPU hours=GPU 수×학습 시간$
>
> 예: 416 GPU hours = V100 1장으로 416시간, 또는 8장으로 약 52시간에 해당.
>
> → 모델 간 총 training compute를 비교하는 지표로 사용.
반면 TimeSformer의 경우 오직 416 Tesla V100 GPU 시간 만제 가장 높은 정확도인 75.8%에 다다랐을 뿐더러 비슷한 GPU 시간으로 SlowFast와 I3D를 학습시키면 각각 70.0%, 71,0%의 정확도로 성능이 떨어짐을 확인할 수 있다.
⇒ SOTA인 3D CNN 모델들의 경우 ImageNet을 통해 사전학습을 한다고 해도 좋은 성능을 내기 위해서는 매우 긴 최적화 시간이 필요하다.
⇒ 반면 TimeSformer의 경우 더 효율적이다.
5.2.3. The Importance of Pretraining
TimeSformer의 경우 learning capacity (parameters)가 큰 만큼 모델을 순수하게 맨땅에서부터 만들기란 어렵다. 그렇기에 영상 데이터에 대해 바로 모델을 학습시키기 보다는 가중치들을 ImageNet으로부터 사전학습하여 초기화를 한다.
- 반면 CNN인 SlowFast의 경우 영상 데이터로부터 직접적으로 배울 수 있지만 높은 학습 비용을 요구한다.
- 저자들은 사전 학습 없이 바로 TimeSformer를 K400에 학습시켰는데, 긴 학습 시간과 추가적인 데이터 증강을 통해 학습이 가능하긴 하지만 정확도가 64.8%로 성능이 그다지 좋지는 않았다.
저자들은 TimeSformer의 세 가지 입력 configuration에 대해 ImageNet-1K와 ImageNet-21K pretraining의 효과를 비교하였다. 이를 통해 더 큰 image pretraining dataset이 video classification 성능에 어떤 영향을 주는지 확인하였다.
실험 조건 정리
- Pretraining dataset 규모
- ImageNet-1K
- ImageNet-21K
- TimeSformer 입력 구성
- 기본형
- 고해상도형
- 장시간 범위형
(# of frames) x (Width pixel of video) x (Height pixel of video)
- TimeSformer :
8x224x224영상 클립에 작동하는 저자들의 모델의 기본 버전 - TimeSformer-HR :
16x448x448영상 클립이라는 고해상도에서 작동하는 버전 (기본 모델보다 frame 수도 늘리고 spatial resolution도 크게 높인 버전) - TimeSformer-L :
96x224x224영상 클립으로 해상도는 기본과 동일하지만 원본 비디오에서 4 frame 간격으로 1 frame씩 샘플링하여 긴 범위에서 작동하는 버전 (더 많은 frame과 더 긴 시간 구간을 처리하도록 설계)
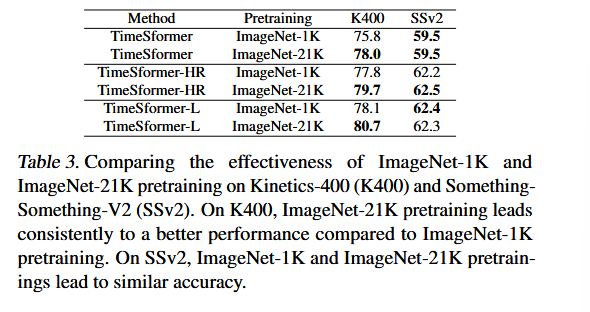
Source: Original Document
결과를 봤을때 동일 Method의 경우 더 큰 규모의 데이터인 ImageNet21K로 진행하는게 K400 (주로 appearance)에서는 유의미하게 좋은 성능을 보이고 있지만 SSv2 (주로 Temporal, motion)의 경우 효과가 미미하거나 오히려 떨어지는 모습을 보여준다.
This makes sense as SSv2 requires complex spatiotemporal reasoning, whereas K400 is biased more towards spatial scene information
⇒ 사전학습은 K400과 같이 spatial scene information 에 의존하는 데이터셋에서 더 좋은 성능을 보인다.
5.2.4. The Impact of Video-Data Scale
영상 데이터의 규모가 성능에 미치는 영향을 알기 위해 저자들은 서로 다른 K400과 SSv2의 부분 데이터셋을 활용해 실험을 설계했다. (전체 영상의 25%, 50%, 75%, 100%)
- 모델은 3D CNN으로 비교된 SlowFast와 I3D를 활용하였다.
- 사전학습의 경우 세모델 모두 ImageNet-1K에 사전학습을 진행했다.
정확하게는 사전학습 된 모델을 가져와서 학습을 진행한 것 같다.
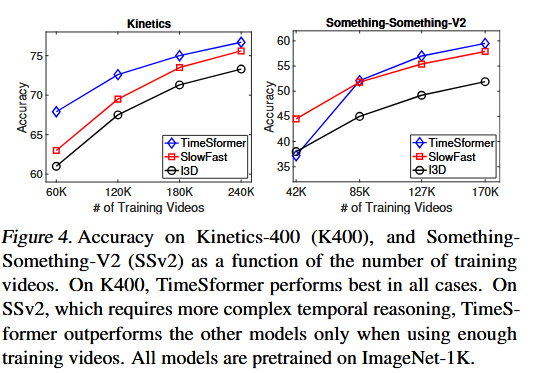
Source: Original Document
- K400의 경우 TimeSformer가 CNN 모델들에 비해 항상 더 좋은 성능을 보여준다.
- SSv2d의 경우 데이터셋의 규모가 작을 때 (42K, 85K)에는 CNN이 좋은 모습을 보여주지만 그 이상으로 커지면 K400과 마찬가지로 TimeSformer가 가장 좋은 성능을 보여준다
- ⇒ 이는 SSv2의 경우 더 복잡한 temporal patterns를 학습해야하기 때문에 TimeSformer가 이 패턴을 효과적으로 학습하기 위해서는 더 많은 예시들이 필요하기 때문이다.
5.3. Varying the Number of Tokens
TimeSformer의 scalability는 SOTA인 3D CNN과 비교해서 고해상도이고 긴 영상에 대해서도 작동할 수 있게 해주는데, 저자들은 이 두가지 조건 (고해상도 & 영상의 긴 길이)이 Transformer에 주어지는 token sequence의 길이에 영향을 미친다고 생각했다.
- 공간 해상도를 높이면 프레임 당 patch의 수 역시 커진다.
- 더 많은 프레임을 사용할 수록 (영상의 길이를 늘릴수록) input token의 수 역시 늘어난다.
⇒ 따라서 이로 인한 효과를 보기 위해 공간축과 시간축 각각에서 token 수를 따로 증가시켜 실험적으로 확인했다
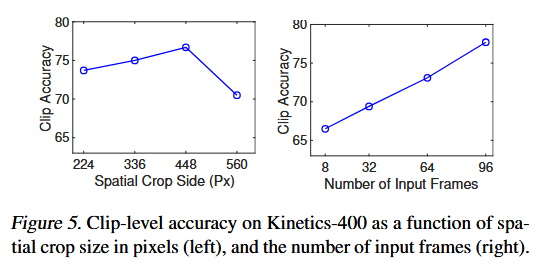
프레임의 수같은 경우 거의 선형적으로 정확도가 오르는 반면, 해상도의 경우 elbow point가 존재했다.
- Spatial axis: 해상도 증가 → frame당 patch 수 N 증가
- Temporal axis: 입력 frame 수 증가 → 시간 방향 token 수 F 증가
- GPU 제한으로 인해 96 프레임 이상은 실험해보지 않았다고 했다 (따라서 96프레임 이상에서의 성능은 증가를 보장할 수 없다)
- 96-frame clip을 사용하는 것은 일반적으로 8~32 frame 입력 처리에 제한되어 있던 당시 convolutional model들과 비교하면 상당히 큰 변화라는 점을 강조한다.
5.4. The Importance of Positional Embeddings
spatiotemporal positional embedding에 대해 중요성을 확인하기 위해 저자는 또 다른 실험을 설계했다
- no positional embedding
- space-only positional embedding
- space-time positional embedding
Source: Original Document
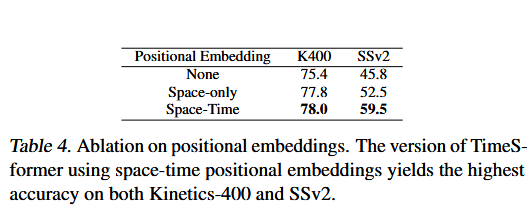
결과는 예상되게도 space-time이 가장 좋은 성능을 보여주었다.
5.5. Comparison to the State-of-the-Art
-
K400
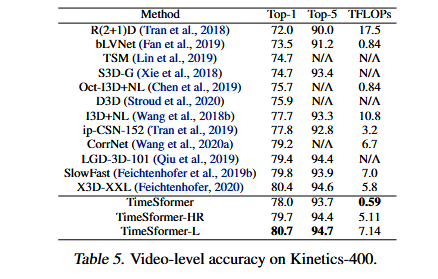
Source: Original Document
- 적은 inference views로도 높은 accuracy
- 기본 TimeSformer는 매우 낮은 inference TFLOPs
- TimeSformer-L은 높은 Top-1 accuracy 달성
-
Actual Runtime
- TFLOPs뿐 아니라 실제 inference 시간에서도 SlowFast보다 훨씬 빠름
-
K600
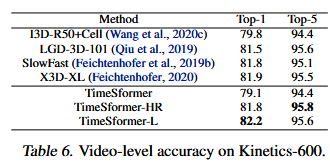
Source: Original Document
- K400과 유사하게 기존 방법들을 능가
- 성능 향상이 다른 dataset에서도 유지됨
-
Effect of Temporal Clips
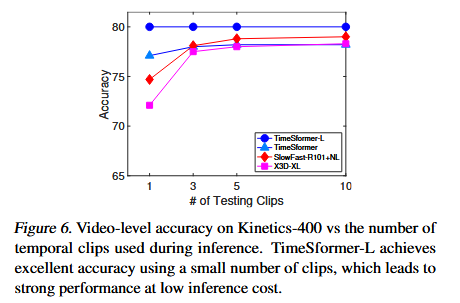
Source: Original Document
- 기존 CNN 모델은 여러 temporal clip이 필요
- TimeSformer-L은 긴 temporal coverage 덕분에 적은 clip으로도 높은 accuracy
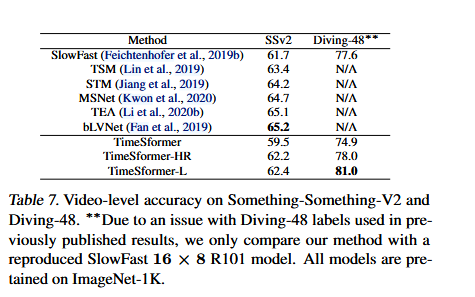
Source: Original Document (“temporally-heavy” datasets)
-
SSv2
-
temporally-heavy dataset에서는 최고 성능에는 못 미침 (최고 성능은 bLVNet이 차지했다.) 하지만 그래도 convolution-free 구조로 경쟁력 있는 성능
💡 bLVNet은 어떤 모델인가?
- bLVNet은 Big-Little-Video-Net의 약자
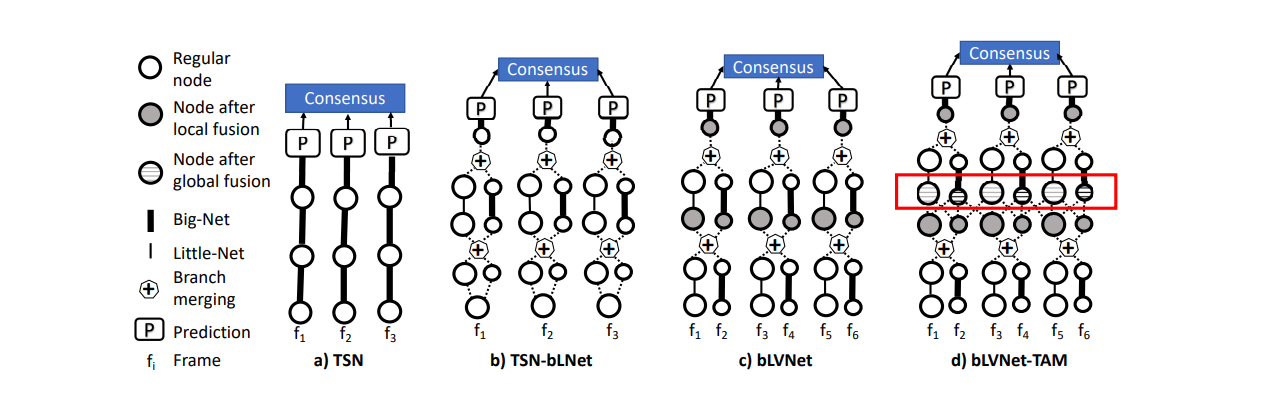
-
Big subnet: 더 깊고 큰 네트워크로 저해상도 frame을 처리
-
Little subnet: 더 작고 가벼운 네트워크로 고해상도 frame을 처리
그런데 bLVNet 자체만으로는 frame 간 temporal relation을 충분히 모델링해야 하므로, 논문에서는 **TAM(Temporal Aggregation Module)**도 같이 제안된다. (bLVNet-TAM)
- TAM은 큰 3D convolution을 쓰는 대신 가벼운 temporal operation을 이용해서 시간축 정보를 결합
-
-
Diving-48
- TimeSformer-L이 SlowFast보다 높은 성능
- long-range temporal modeling의 가능성 확인
TimeSformer의 장점은 단순히 정확도가 높은 것뿐 아니라, 적은 temporal/spatial views와 낮은 실제 inference cost로 경쟁력 있는 성능을 달성하며, 특히 TimeSformer-L은 긴 temporal context를 한 번에 처리함으로써 multi-clip inference의 필요성을 줄인다는 점이다.
5.6. Long-Term Video Modeling
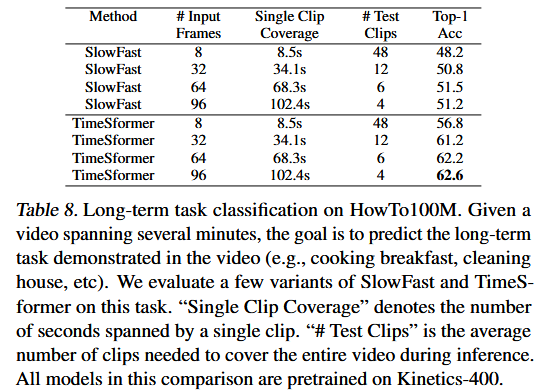
마지막으로 TimSformer를 long-term video modeling에 HowTo100M를 활용해서 적용해보았다.
💡 HowTo100M이란 어떤 데이터셋인가? : HowTo100M은 23K개의 서로 다른 과업에 대해서 사람들이 수행하는 것을 담은 1M의 교육 웹 영상을 포함하는 데이터셋이다
평균 영상 길이 : 7분
각 영상은 영상에서 제시도니 과업을 라벨로 가지고 있다.
- 실험을 위해 최소 100개의 예시를 가지고 있는 카테고리만 실험에 활용하였다.
- 1059개의 카테고리고 구성되었으며 약 120천개의 영상이 실험에 활용됨
- 팔만오천개는 학습에, 나머지 삼만오천개는 평가에 활용
Source: Original Document
- 네 가지의 입력 프레임 변수를 두고 SlowFast와 TimeSformer를 비교하였다.
- 추론에 활용되는 영상의 경우 중복구간이 없게 설계했으며, 영상 수즌의 분류는 clip prediction의 평균을 계산해서 진행되었다.
- 결과적으로 같은 Single Clip coveragae에 대해서 TimneSformer가 항상 SlowFast보다 좋은 성능을 보여주었다.
- 또한 영상의 길이가 길어질 수록 TimeSformer의 성능이 올랐다 (Elbow point가 존재한 SlowFast와는 다른 양상)
Source: Original Document
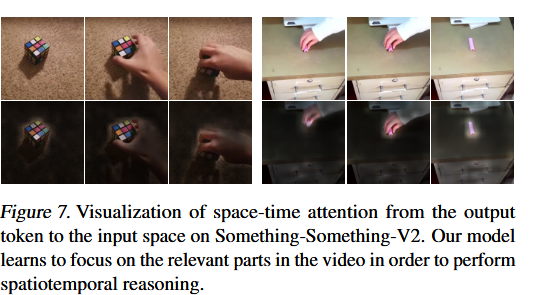
spatiotemporal attention을 실제로 시각화할 경우 SSv2에서 의미 있는 객체에 어텐션이 집중됨을 볼 수 있다.
Source: Original Document
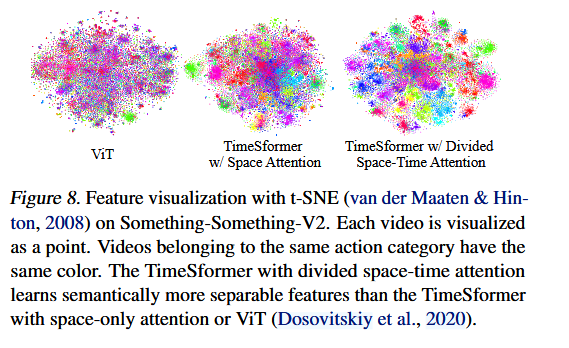
또한 SSv2에 바로 fine tuning을 진행한뒤의 feature에 대해 tSNE를 활용해서 시각화한 결과 ViT 나 Space only 보다 space time attention이 훨씬 더 비슷한 색상의 카테고리를 잘 묶어놓는 것을 알 수 있다.
6. Limitation By GPT
In the future, we plan to extend our method to other video analysis tasks such as action localization, video captioning and question-answering
-
Large-scale pretraining/data dependency
TimeSformer는 높은 model capacity를 가지기 때문에 ImageNet pretraining의 영향이 크며, scratch training에서는 성능이 크게 하락하였다. 특히 SSv2에서는 충분한 양의 video data가 주어졌을 때에야 CNN baseline을 능가하여, complex temporal patterns를 학습하는 데 많은 training examples가 필요할 가능성을 보였다.
-
Not consistently superior on temporally-heavy tasks
Temporal self-attention을 통해 motion과 temporal dependency를 학습할 수 있지만, SSv2에서는 당시 temporal-specialized architectures보다 낮은 성능을 기록하였다. 따라서 TimeSformer가 모든 종류의 temporal reasoning에서 우월하다고 보기는 어렵다.
-
Scalability still has computational limits
Divided Space-Time Attention은 Joint Attention보다 훨씬 효율적이지만 input frame과 spatial resolution이 증가하면 계산량과 memory 사용량 역시 증가한다. 실제로 저자들은 GPU memory limitation으로 96 frames보다 긴 clip을 실험하지 못했다.
-
Evaluation is mainly limited to video classification
논문의 실험은 주로 video-level action classification에 집중되어 있으며, action localization, captioning, video QA 등의 다른 video understanding task에 대해서는 검증하지 않았다. 저자 역시 이를 향후 연구 방향으로 제시한다.
-
Space-time factorization may sacrifice direct joint interactions
Divided Attention은 temporal과 spatial attention을 순차적으로 factorize하여 효율성을 얻지만, Joint Attention처럼 임의의 (p,t)와 (p′,t′)를 한 단계에서 직접 비교하지는 않는다. 이것이 실제 temporal correspondence에 어떤 영향을 주는지는 논문에서 충분히 분석되지 않았다.