Paper Information
Title: SAM 2: Segment Anything in Images and Videos
Authors: Nikhila Ravi, Valentin Gabeur, Yuan-Ting Hu, Ronghang Hu, Chaitanya Ryali, Tengyu Ma, Haitham Khedr, Roman Rädle, Chloe Rolland, Laura Gustafson, Eric Mintun, Junting Pan, Kalyan Vasudev Alwala, Nicolas Carion, Chao-Yuan Wu, Ross Girshick, Piotr Dollár, Christoph Feichtenhofer
Affiliation: Meta AI / FAIR
arXiv ID: 2408.00714
Topic: Promptable Video Segmentation, Video Object Segmentation, Foundation Model, Streaming Memory, Interactive Segmentation, Image Segmentation
Venue: arXiv, 2024
Date: July 29, 2024 (Meta 공개), arXiv 제출 August 1, 2024
Pages: 44 pages (main paper + appendix 기준)
Project / Code: Meta Segment Anything 2
Dataset: SA-V (Segment Anything Video Dataset) : 약 51,000개의 실제 영상과 600,000개 이상의 masklet을 포함한 대규모 비디오 segmentation 데이터셋.
1. One-line Summary
SAM 2는 SAM의 promptable segmentation을 비디오로 확장해 임의 프레임의 point·box·mask prompt를 전체 영상의 masklet으로 전파하고 추가 prompt로 수정할 수 있게 한 통합 모델이다. Hiera feature와 예측 mask를 memory로 저장해 이후 프레임에 attention으로 활용하며, SAM 1과 유사한 model-in-the-loop data engine으로 SA-V를 구축했다.
a foundation model towards solving promptable visual segmentation in images and videos
(i) extending the promptable segmentation task to video
(ii) equipping the SAM architecture to use memory when applied to video
(iii) the diverse SA-V dataset for training and benchmarking video segmentation.
2. Problem
AR, VR, robotics, 자율주행, 영상 편집등에서는 static한 image-level segmentation이 아니라 그 이상의 temporal localization을 요구하게 된다.
영상 속 segmentation은 특히 the spatio-temporal extent of entities에 집중한다.
-
the spatio-temporal extent of entities : 영상 속 어떤 객체(entity)가 공간적으로 어디에 있고, 시간적으로 언제부터 언제까지 존재하는지의 범위
-
영상에서는 motion, deformation, occlusion, lighting changes와 같은 요소들로 인해appearance 측면에서 분명한 차이를 겪는다.
-
camera motion, blur, lower resolution등으로 인해 영상은 종종 사진보다 더 낮은 퀄리디를 보이고 게다가 대향의 프레임에 대해서 효율적으로 처리를 하는 것이 주요 과제다.
SAM 2에서는 Promptable Visual Segmentation (PVS) task에 집중하는데 이 과제는 영상 도메인에서 image segmentation을 일반화하는 과제라고 한다.
비디오의 임의의 프레임에 점(point), 박스(box), 또는 마스크(mask)를 입력으로 받아 관심 있는 객체 영역을 지정
모델은 해당 객체에 대해 비디오 전체에서의 시공간 마스크, 즉 masklet을 예측
한 번 masklet이 생성된 뒤에는 다른 프레임에 추가적인 프롬프트를 제공하여 그 결과를 반복적으로 수정하고 개선 가능
- 다른 프레임에서 다시 힌트를 줄 수 있다 (iteratively refined)
: 하나의 객체에 대해 시간축을 따라 이어지는 mask 집합
2.1. Related work
2.1.1. Image segmentation
SAM에서 promptable image segmentation task를 소개했는데 이건 관심 대상에 대한 bbox, point가 pormpt로 주어지면 이에 대해 유효한 segmentation mask를 출력하는 것이 목표
| 항목 | Original SAM |
|---|---|
| Input | Image + prompt |
| Prompt | point, box, coarse mask |
| Output | prompt가 가리키는 객체의 binary segmentation mask |
| 데이터 | SA-1B: 약 11M images, 1B+ masks |
| 핵심 구조 | Image Encoder(ViT) + Prompt Encoder + Mask Decoder |
| 목표 | 새로운 객체/도메인에도 prompt만 주면 zero-shot segmentation |
| 핵심 한계 | 세밀한 경계, 계산량, domain shift, video temporal consistency |
SAM 이후의 image segmentation 관련 연구들
-
더 세밀한 마스크에 학습하기 위한 High-Quality output token 도입
-
SAM efficiency 개선
-
mdeical imaging remote sensing, motion segmentation, camouflaged object dectection과 같은 분야 적용
| 연구 | 도입 개념 | 의의 |
|---|---|---|
| HQ-SAM — Ke et al., 2024 | 기존 SAM에 High-Quality Output Token을 추가하고, 경계와 세부 구조가 정교하게 라벨링된 mask로 학습 | SAM이 대략적인 객체 영역은 잘 잡지만 얇은 구조, 세밀한 경계, 작은 디테일에서 떨어지는 문제를 보완. 즉 “segment anything” → “segment anything more precisely”에 가까운 연구입니다. |
| EfficientSAM — Xiong et al. | SAM의 무거운 ViT encoder 대신 더 작은 encoder를 사용하고, masked-image pretraining을 활용 | SAM의 큰 계산량을 줄이면서 segmentation 능력을 최대한 유지하려는 접근. edge/mobile 환경에서 SAM을 사용할 가능성을 키웠습니다. |
| MobileSAM — Zhang et al., 2023 | SAM의 큰 image encoder를 knowledge distillation으로 작은 encoder로 교체 | SAM의 prompt encoder와 mask decoder는 유지하면서 병목인 image encoder를 작게 만들어 모바일·실시간 활용 가능성을 높였습니다. |
| FastSAM — Zhao et al., 2023 | SAM 자체를 단순 축소하기보다는 YOLO 계열 segmentation 구조로 빠른 “segment anything” 기능을 구현 | 범용 promptable segmentation이라는 SAM의 목적은 유지하면서 속도를 대폭 높이는 대안적 구조를 제시했습니다. 즉 SAM architecture 자체가 반드시 필요한지에 대한 실용적 대안입니다. |
| Method | SAM에서 무엇을 유지? | 무엇을 변경? | 추가 데이터/학습 | 해결하려는 문제 |
|---|---|---|---|---|
| SAM | - | - | SA-1B: 11M images, 1B+ masks | 범용 promptable segmentation |
| HQ-SAM | SAM backbone 대부분 | HQ token + feature fusion | 44K fine masks | 세밀한 boundary |
| MobileSAM | Prompt encoder + mask decoder | ViT-H → TinyViT | Distillation | 계산량 |
| EfficientSAM | SAM task/interface | lightweight encoder + SAMI pretraining | SA-1B fine-tuning | 계산량 + representation |
| FastSAM | promptable task 개념 | architecture 자체를 instance segmentation으로 변경 | SA-1B 일부 | 속도 |
| MedSAM | SAM 기본 구조 | medical adaptation + prompt 제한 | 1.57M medical image-mask pairs | domain shift |
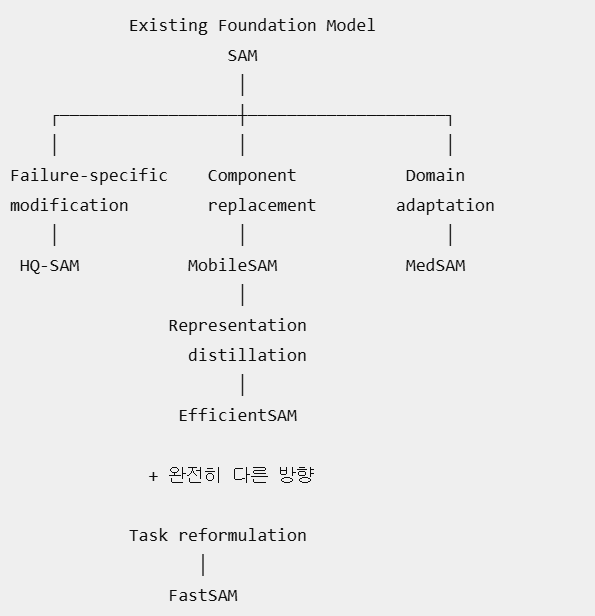
Source: Diagram generated by ChatGPT
기존의 연구를 개선하기 위해서는 1. 모델이 성능을 보이지 못했던 부분에 대해 특화된 개선을 하거나, 2. component를 대체하거나, 3. domain에 적용하는 등의 접근이 필요하다
2.1.2. Interactive Video Object Segmentation (iVOS)
사용자가 영상의 일부 프레임에서 점, 박스, scribble, mask 같은 힌트를 주면, 모델이 관심 객체를 영상 전체에서 분할하고, 필요하면 추가 힌트로 결과를 수정하는 task
이전 연구 흐름
-
graph-based optimization to guide the segmentation annotation process
-
adopt a modular design, converting user inputs into a mask representation on a single frame and then propagating it to other frames.
click이 손수 라벨링하는 것보다 훨씬 쉬운 interactive video segmentation 데이터 수집 방식이기에 이를 활용해서 mask나 point에 기반한 video tracker를 활ㅇ용해 SAM의 활용을 연구하는 분야도 있다
⇒ 하지만 이 분야는 아래의 한계점이 있었다.
Image에서 잘 작동한다고 해서 SAM이 영상 프레임에 바로 잘 활용되지는 못했다.
또한 모델의 실수를 교정하는 방식에 대해 정립되지 않았는데 그때 당시에는 SAM을 활용해서 각 프레임에 대해 다시 annotation을 하거나 다시 tracking을 시작하는 방법이 있었다.
2.1.3. Video Object Segmentation (VOS)
VOS 과제의 경우 object mask를 첫 프레임에서 입력값으로 주어지는데 이는 반드시 영상 전체에서 정확하게 tracking 되어야 했다.
semi-supervised VOS라고도 불렸는데 input mask가 어찌보면 첫 프레임에서만 발견가능한 객체에 대해서 supervision signal을 준 것이라고도 볼 수 있었기 때문이다.
이전의 DL 기반의 접근은 주로 첫 프레임의 annotated mask를 이용해 test-time에 해당 target object에 모델을 fine-tuning한다는 흐름이었는데 target obejct에 모델을 적응시키기 위한 방법이었다
- 장점은 특정 target에 매우 잘 적응할 수 있다는 것이지만, inference 시 학습이 필요하기 때문에 매우 느리다는 단점이 있었다.
이후에는 offline-trained model이 빠른 성능을 보였는데 이 방식에서는 inference 때 새로 fine-tuning하지 않고, 훈련 단계에서 이미 reference mask + current frame ⇒ current mask관계를 학습한다. 첫 프레임의 reference mask나 이전 프레임의 예측 결과를 conditioning information으로 활용하여 현재 프레임의 mask를 예측하였다.
그 뒤에는 multi-conditioning이 제시되었는데 이는 RNN과 transformer를 활용해서 여러 과거 프레임의 feature와 object mask 정보를 memory/temporal representation으로 축적하고, 현재 프레임 segmentation을 여러 reference frame에 conditioning하도록 발전하였다.
이러한 Semi-supervised VOS는 일종의 Promptable VIsual Segmentation (PVS) task의 특이 사례로 보여질 수 있는데 첫 프레임에 대해 mask prompt가 주어지는 것으로 해석 가능하기 때문이다
prompt가 반드시 첫 프레임에 있고, 형태가 high-quality mask이며 이후에는 보통 추가 interaction이 없기 때문
주목할만한 점은 VOS에서 첫 프레임에 대해 high-quality object mask를 annotate하는 것은 실제로는 어렵고 추론에서 시간을 많이 잡아먹었다고 한다.
segmentation annotation을 줄이기 위해 VOS를 사용하는데 VOS를 시작하려면 먼저 고품질 segmentation annotation이 필요하다.
2.1.4. Video segmentation datasets
이전에도 VOS task를 지원하기 위해 많은 데이터셋이 제시되었다.
-
DAVIS와 같은 초기 VOS dataset은 고품질 annotation을 포함하지만 deep-learning 기반 접근을 하기에는 규모가 제한적이었다.
-
YouTube-VOS의 경우 첫 VOS 대규모 데이터셋이었다
-
알고리즘이 나아지고 벤치마크 성능이 성숙해짐에 따라 VOS task의 난도를 올리고 task specific한 방향으로 접근이 되었다.
-
occlusion, long videos, extreme transformation, object diversity, scene diversity
- Occlusion : 타겟 객체가 다른 객체나 배경 구조물에 의해 일시적으로 가려졌다가 다시 나타날 때(Re-appearance) 객체의 정확한 픽셀 마스크를 유지하고 추적하는 기술
-
Segment Anything을 하기에는 기존의 데이터셋은 특정 객체에 대한 것이 많았고 객체 전체에 대해 커버 (부분적인 마스크 지원 X)한다는 한계점이 있었다.
3. Method
3.1. Task : Promptable Visual Segmentation
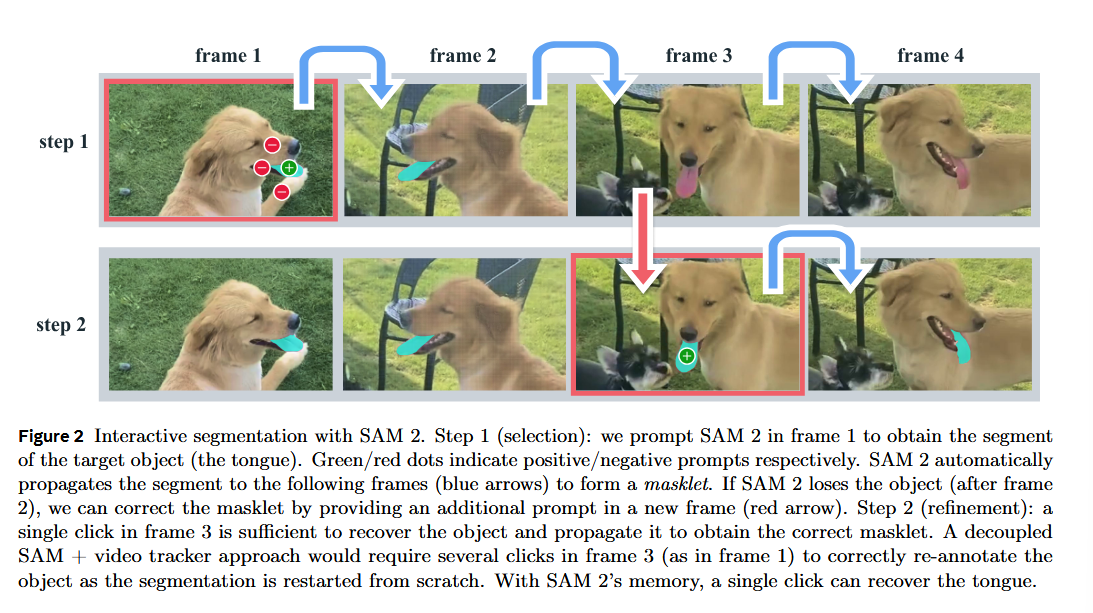
Prompt는 positive/negative click, bounding box, mask 등의 형태로 주어질 수 있으며, 사용자는 이를 통해 어떤 객체를 segment할 것인지 지정하거나 기존 model prediction의 오류를 수정할 수 있다.
특정 프레임에 prompt가 주어지면, interactive experience를 위해 모델은 우선 해당 프레임에서 prompt와 일치하는 유효한 object segmentation mask를 즉시 출력해야 한다.
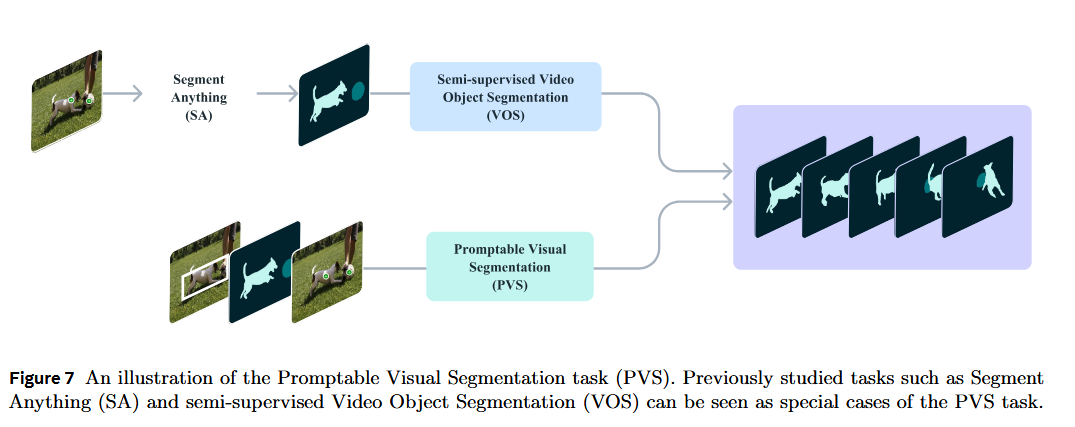
Source: Original Document
하나 이상의 프레임에 prompt가 주어진 이후에는, 모델이 이러한 prompt들을 조건으로 삼아 동일한 객체를 비디오 전체에서 localize하고 각 프레임의 segmentation mask를 예측해야 한다. 이 시간적으로 연결된 object mask sequence를 masklet이라고 한다.
이후에도 사용자는 비디오의 임의의 프레임에 추가 prompt를 제공할 수 있으며, 모델은 새 정보를 반영하여 전체 비디오에 걸친 masklet을 반복적으로 수정(refine)해야 한다.
3.2. Model : Segment Anything Model 2
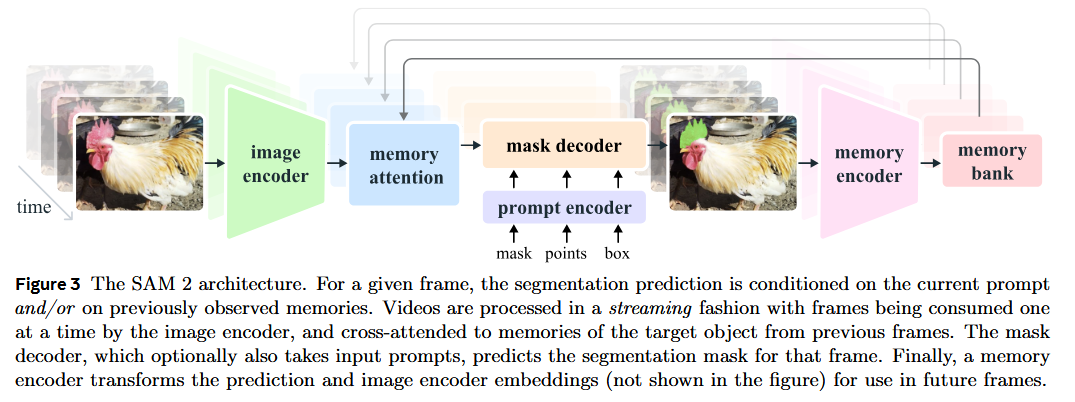
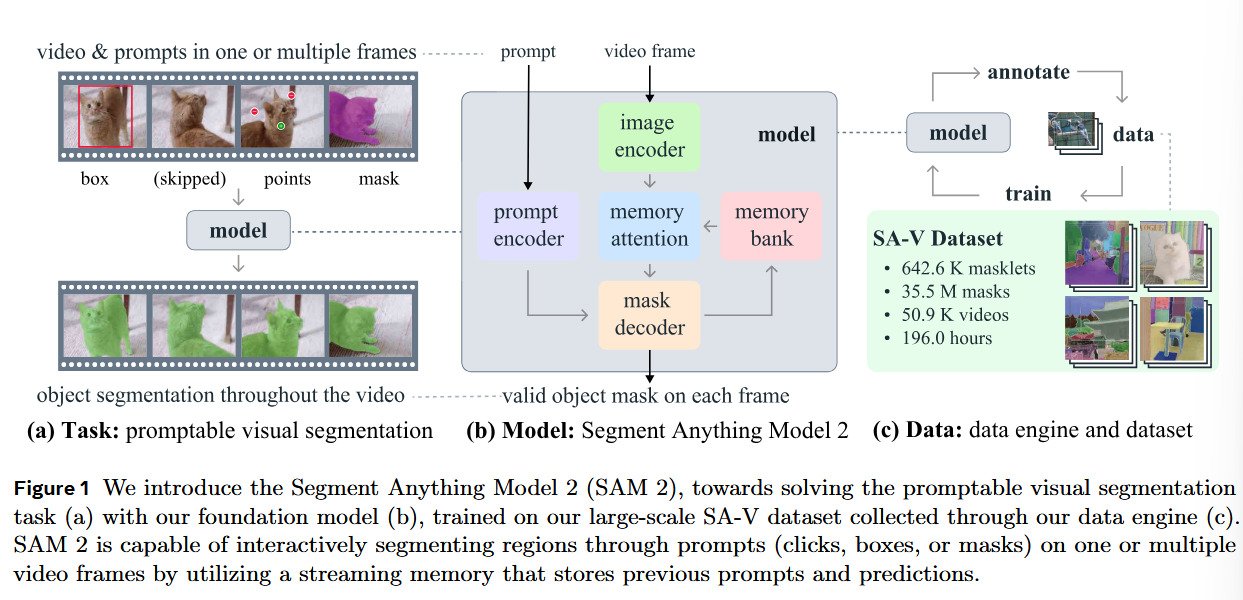
A promptable and light-weight mask decoder takes an image embedding and prompts (if any) and outputs a segmentation mask for the frame. Prompts can be iteratively added on a frame in order to refine the masks.
모델은 기존의 SAM에서 가장 큰 차이점이 temporal information을 담기 위한 memory attention 모듈을 추가했다는 점이다.
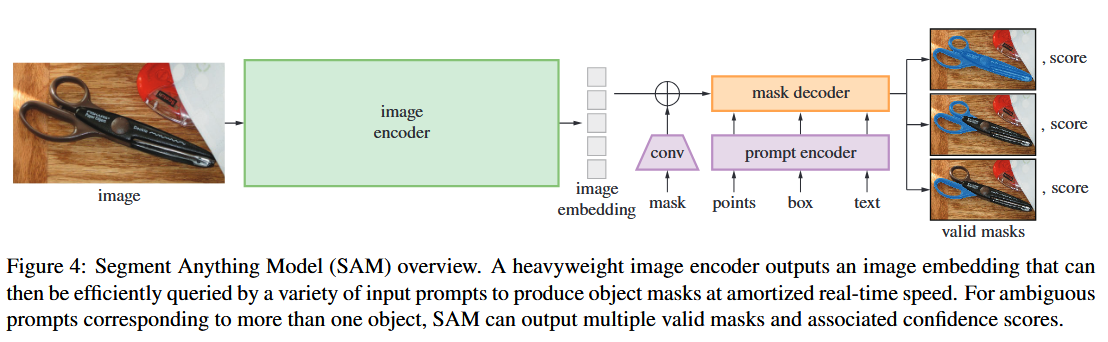
Source: Segment Anything, https://arxiv.org/abs/2304.02643
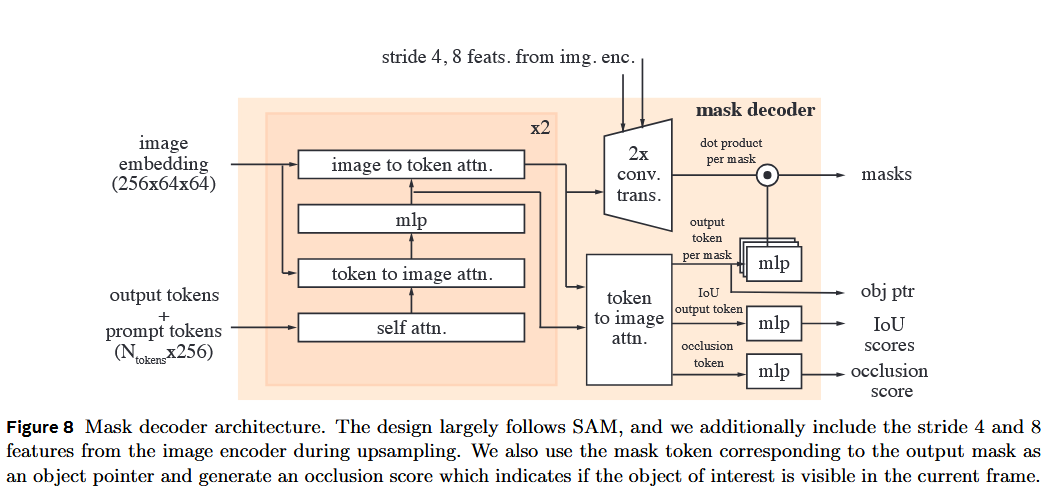
기존 SAM에서는 Image encoder 출력물을 바로 mask decoder에 conv layer를 통해서 변환 뒤에 넘겨준다.
Source: Original Document
하지만 SAM 2 decoder에서 활용되는 프레임 임베딩은 image dncoder로부터 바로 출력되는게 아니라 과거 prediction과 prompted frames에 기반하여 conditioned on memories가 된다.
⇒ 그래서 시간의 방향이 양방으로 가능했다 (현재 프레임 기준으로 해서 미래의 프레임으로부터 prompted frames가 오는 것도 가능했다.)
프레임에 대한 memories는 현재 예측에 기반한 memory encoder에 의해 생성되면서 memory bank에 저장이 된다.
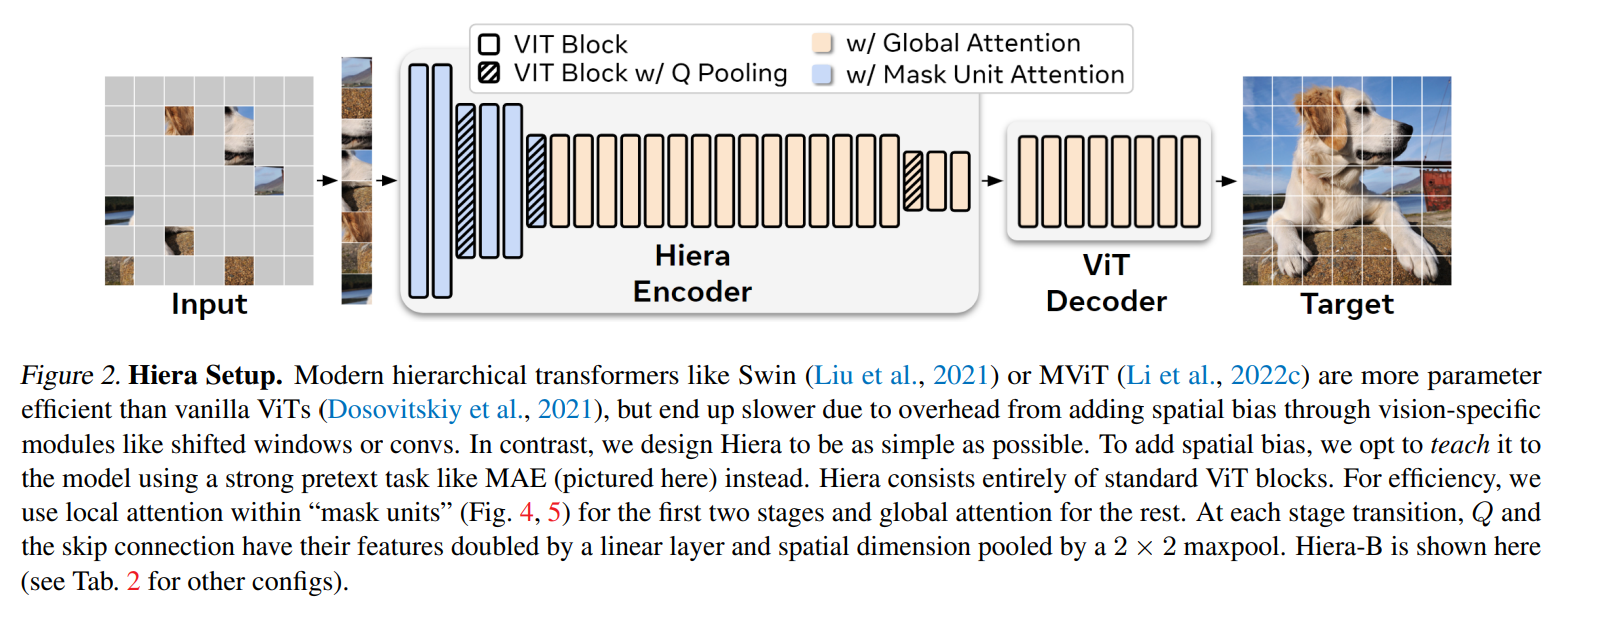
❓ Hiera feature란 무엇인가?
Source: Hiera: A Hierarchical Vision Transformer without the Bells-and-Whistles, https://arxiv.org/pdf/2306.00989
말 그대로 hierarchical architecture.
일반적인 ViT는 이미지를 일정 크기 patch로 나눈 뒤 거의 같은 해상도의 token sequence를 끝까지 유지하는 편인데, Hiera는 CNN처럼 stage가 진행될수록 spatial resolution을 줄이고 feature hierarchy를 만든다
관심 있다면 같이 보면 좋은 블로그 글 : https://kimjy99.github.io/논문리뷰/hiera/
Source: Original Document
memory encoder가 새로운 image encoder를 하나 더 쓰지 않는다
⇒ 현재 프레임에서 이미 만든 image embedding을 재사용하고 여기에 현재 predicted mask 정보를 결합해서 “이 프레임에서 target object가 어떻게 보였는가”를 표현하는 memory feature로 memory encoder를 구성한다.
현재 frame의 Image embedding이 query가 되고 memory bank에 저장된 과거 memory들이 key/value (attention 형태)로 저장된다
Memory bank 자체는 RNN이나 별도의 Transformer backbone이 아니라, 과거 프레임에서 생성된 spatial memory feature와 object pointer token을 저장하는 token-based memory storage다. 그리고 현재 프레임은 Transformer의 cross-attention을 통해 이 memory bank를 조회한다.
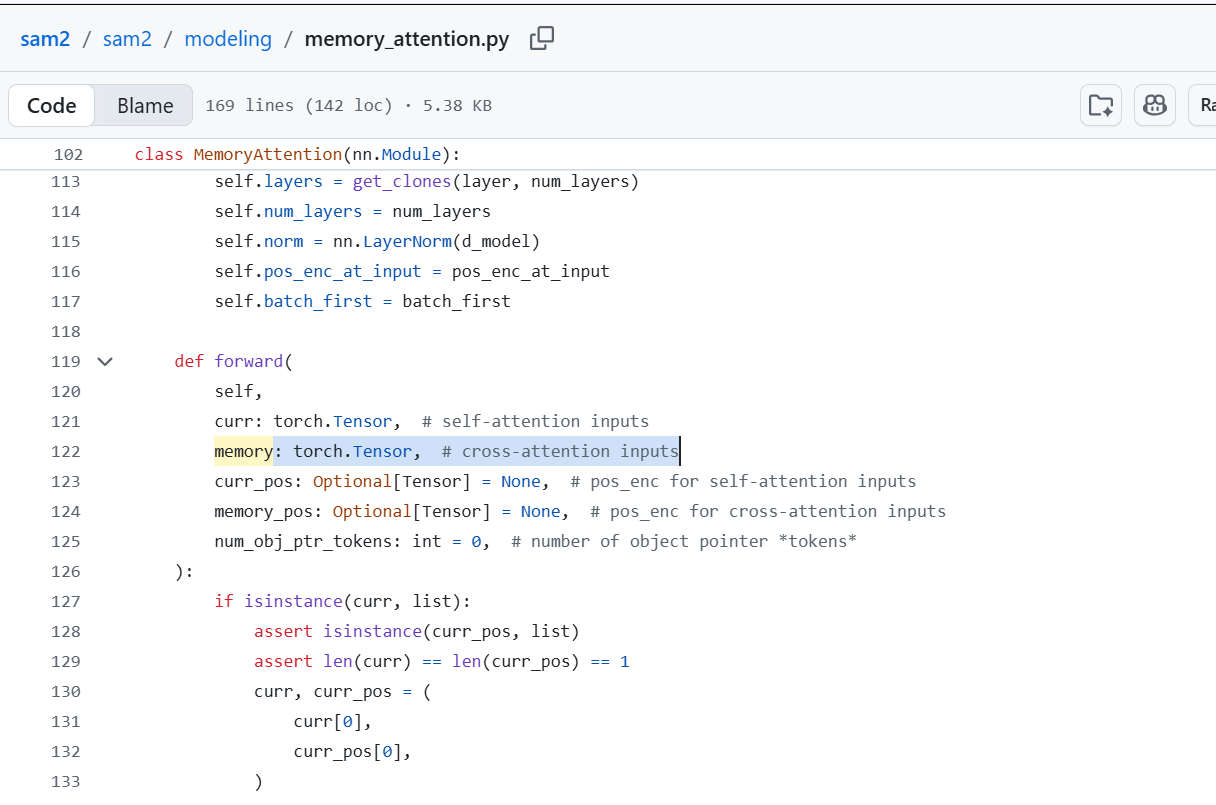
❓ 실제로 어떻게 memory를 저장하고 불러오는가? memory attention에서는 Tensor의 형태로 memory를 입력받고 그에 대해서 attention의 Q K V 구조로 해당 임베딩이 출력되는 구조인 것 같다
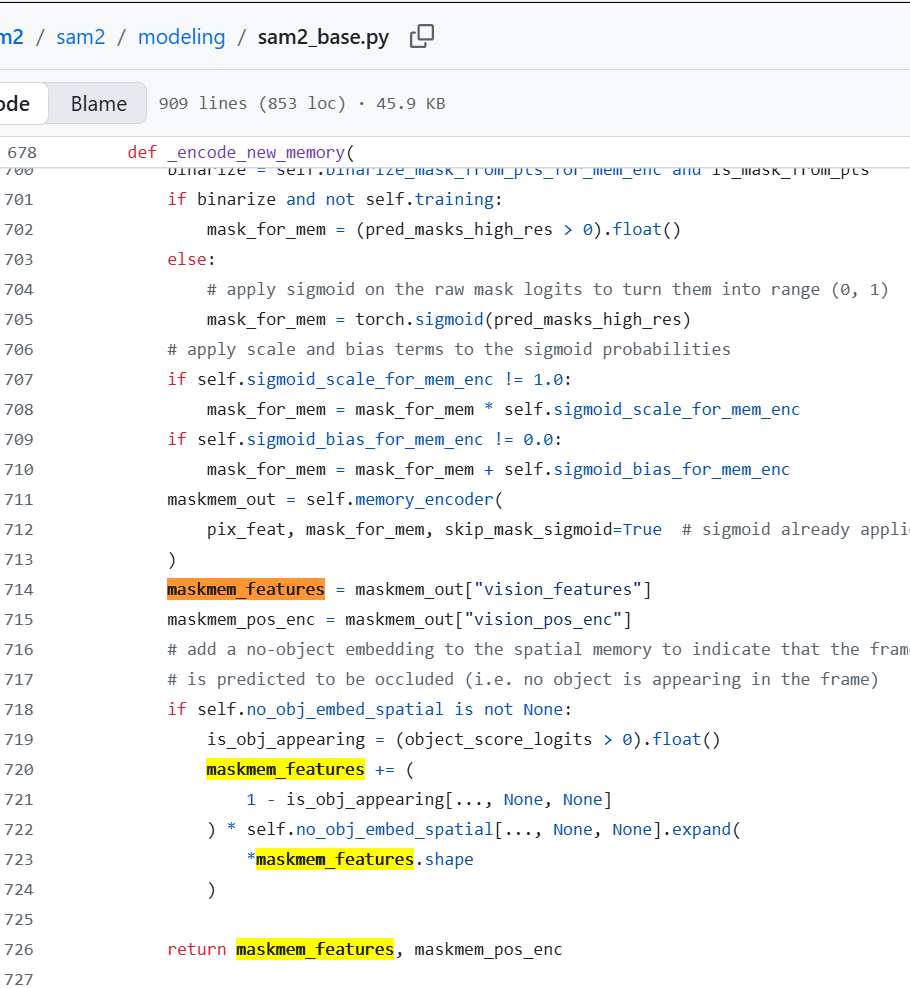
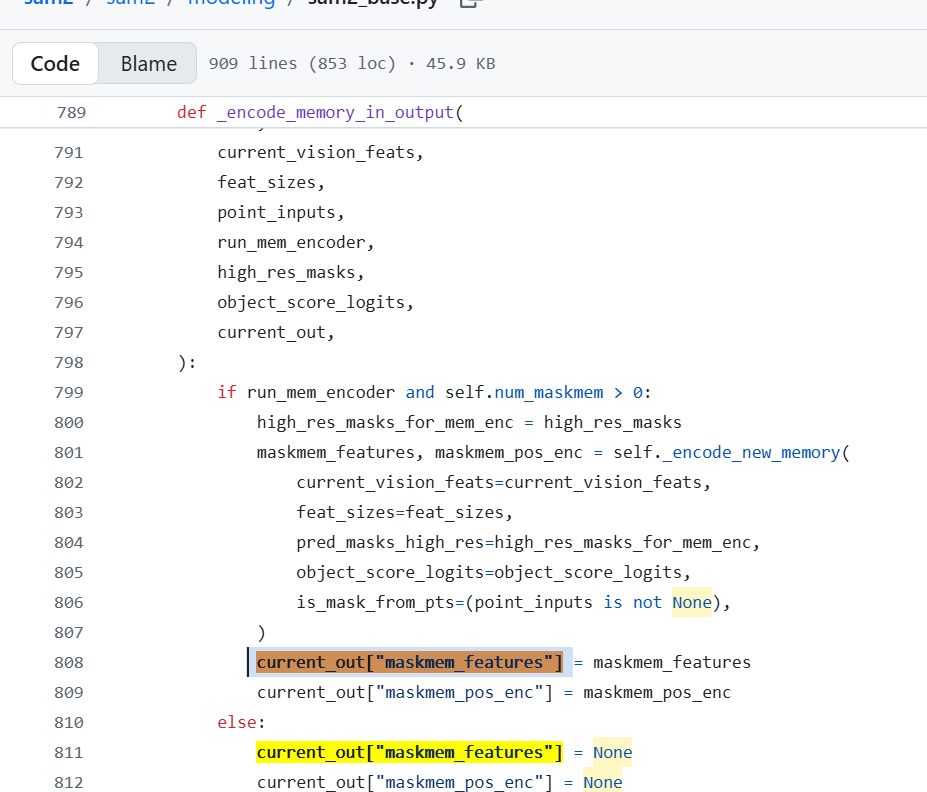
그럼 이 텐서는 어디서 왔을까 아래 코드는 SAM2_base 코드인데 새롭게 memory를 encode하는 과정을 보면 maskmem_out이라는 것으로 feature를 불러오고 새롭게 ㅈ
current_out으로 명시된 python dictionary에 저장되는 것을 볼 수 있다.
current_out = {
    "pred_masks": ...,
    "pred_masks_high_res": ...,

    "obj_ptr": Tensor(...),

    "maskmem_features": Tensor(...),
    "maskmem_pos_enc": [...]
}
⇒ 이후
current_out들이 상위 코드에서 프레임 번호를 key로 해서output_dict에 보관 나중에memory = torch.cat(to_cat_memory, dim=0)이런 식으로 하나로 합쳐져 긴 Tensor가 되고 이에 대해서 attention query를 진행하는 방식SAM 2는 frame number를 이용해 어떤 memory tensors를 후보군으로 불러올지 먼저 선택하고, 실제 attention에서는 그 tensor 내부의 feature token들을 Key/Value로 사용하여 현재 frame의 Query와 feature similarity를 계산합니다.
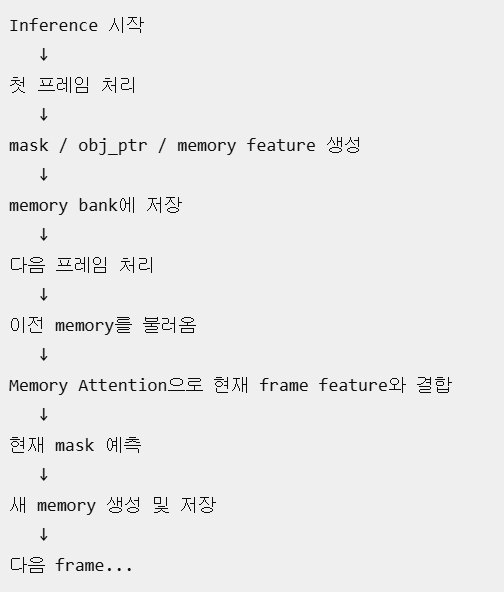
이 memory bank는 실제 사용자가 inference를 진행하면서 동적으로 생성 및 관리된다.
3.3. Data : Data Engine and Dataset
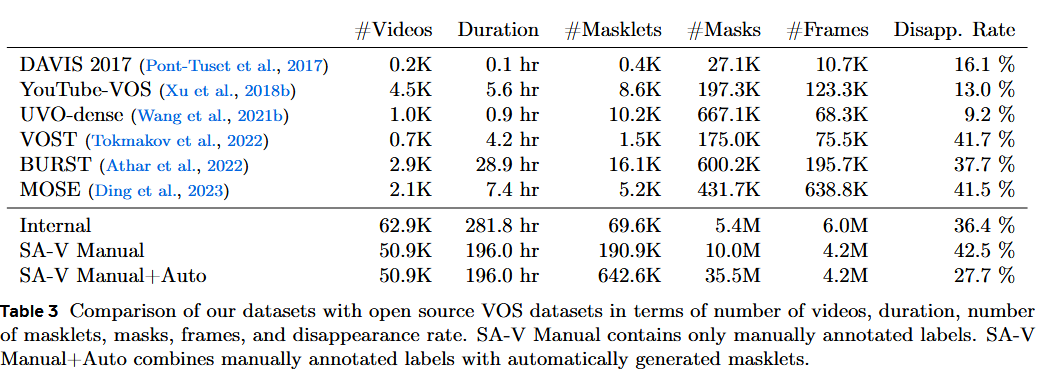
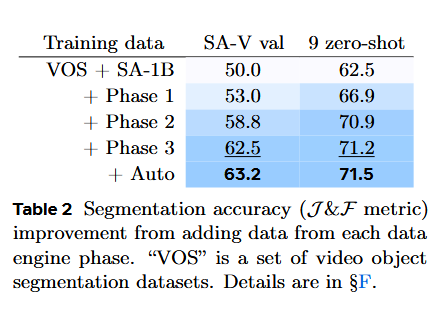
Our final Segment Anything Video (SA-V) dataset consists of 35.5M masks across 50.9K videos, 53× more masks than any existing video segmentation dataset.
기존의 SAM에서 활용되었던 data engine과 데이터셋 생성 구조와 비슷하다
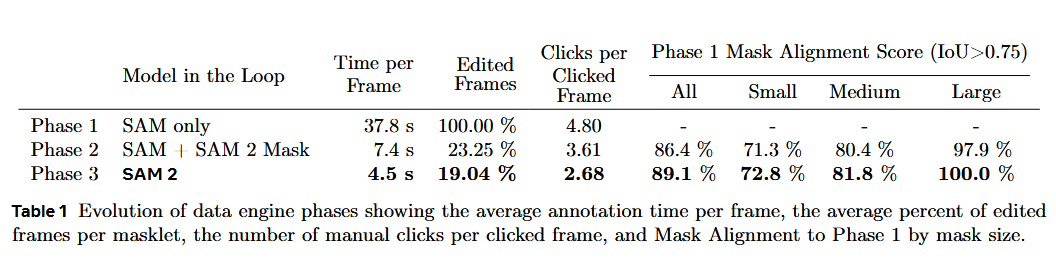
| Phase | 사용 모델 | Annotator 역할 | 결과 |
|---|---|---|---|
| Phase 1 | SAM only | 모든 프레임을 직접 segmentation | 느리지만 고품질 기준 데이터 |
| Phase 2 | SAM + SAM 2 Mask | 첫 프레임 mask 생성 → propagation → 틀린 프레임은 다시 mask 수정 | annotation 속도 크게 향상 |
| Phase 3 | Full SAM 2 | 초기 prompt + 필요할 때 click으로 correction | 가장 효율적인 interactive annotation |
Source: Original Document
SAM 2의 data engine은 SAM 1과 동일하게 model-in-the-loop 방식으로 모델 개선과 데이터 수집을 반복하지만, 이미지 단위 mask 생성에서 더 나아가 temporal mask propagation과 interactive correction을 단계적으로 도입하여 video masklet annotation 비용을 줄이고 SA-V를 확장하였다.
Source: Original Document
4. Key Idea
SAM 2 is equipped with a memory that stores information about the object and previous interactions, which allows it to generate masklet predictions throughout the video, and also effectively correct these based on the stored memory context of the object from previously observed frames.
이전 모델인 SAM을 영상 도메인에 확장하는데 영상 프레임을 한번에 memory attention 모듈을 활용해서 한번에 처리한다.
메모리가 비면 SAM과 같이 이미지 처리에 활용할 수 있다.
Source: Original Document
5. Result
5.1. Zero-shot experiments
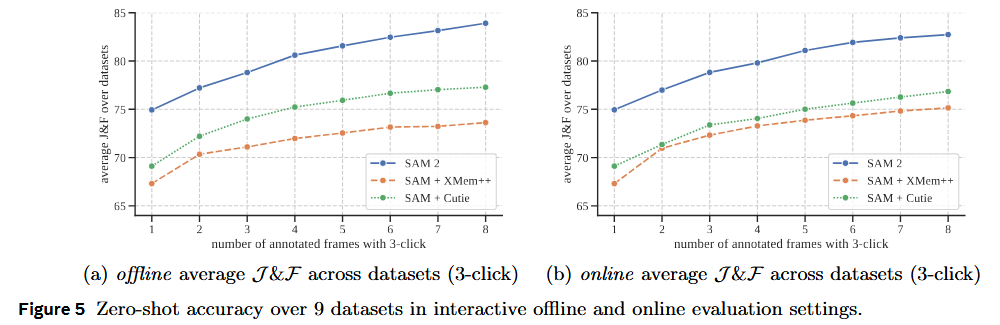
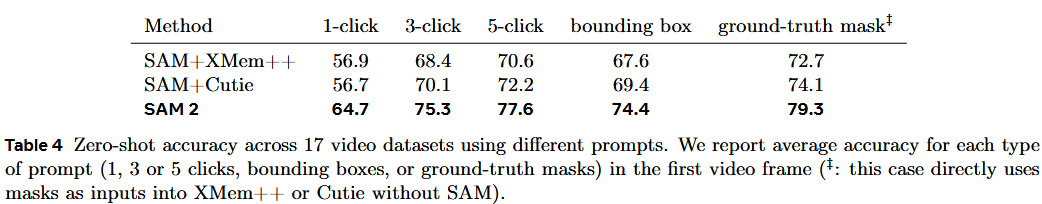
SAM 2는 interactive video segmentation에서 기존 SAM+tracker 조합보다 적은 interaction으로 더 높은 성능을 보였고, conventional VOS에서도 전문 tracker보다 우수했으며, image segmentation에서는 기존 SAM보다 빠르면서도 더 높은 정확도를 유지했다.
이 실험 결과에서는 J & F metric를 활용했다
❓ J & F metric은 어떤 지표인가? VOS(Video Object Segmentation)에서 자주 쓰는 표준 평가 지표로, 영역 정확도 와 경계 정확도 를 평균한 지표
: Jaccard Index (Intersection over Union, IoU)
⇒ 예측 mask가 GT mask의 전체 영역을 얼마나 잘 겹쳐 맞췄는지: Boundary F-measure
⇒ pixel 전체가 아니라 boundary pixel이 얼마나 가까이 맞았는지
5.1.1. Promptable Video Segmentation
SAM + tracker라는 기존 modular 설계보다, prompt 이해와 temporal propagation을 하나의 모델로 통합한 SAM 2가 interactive refinement에서 더 효율적이다.
source: Original Document
XMem++와 Cutie 는 당시 VOS에서 SOTA 모델이다
-
XMem++ https://max810.github.io/xmem2-project-page/
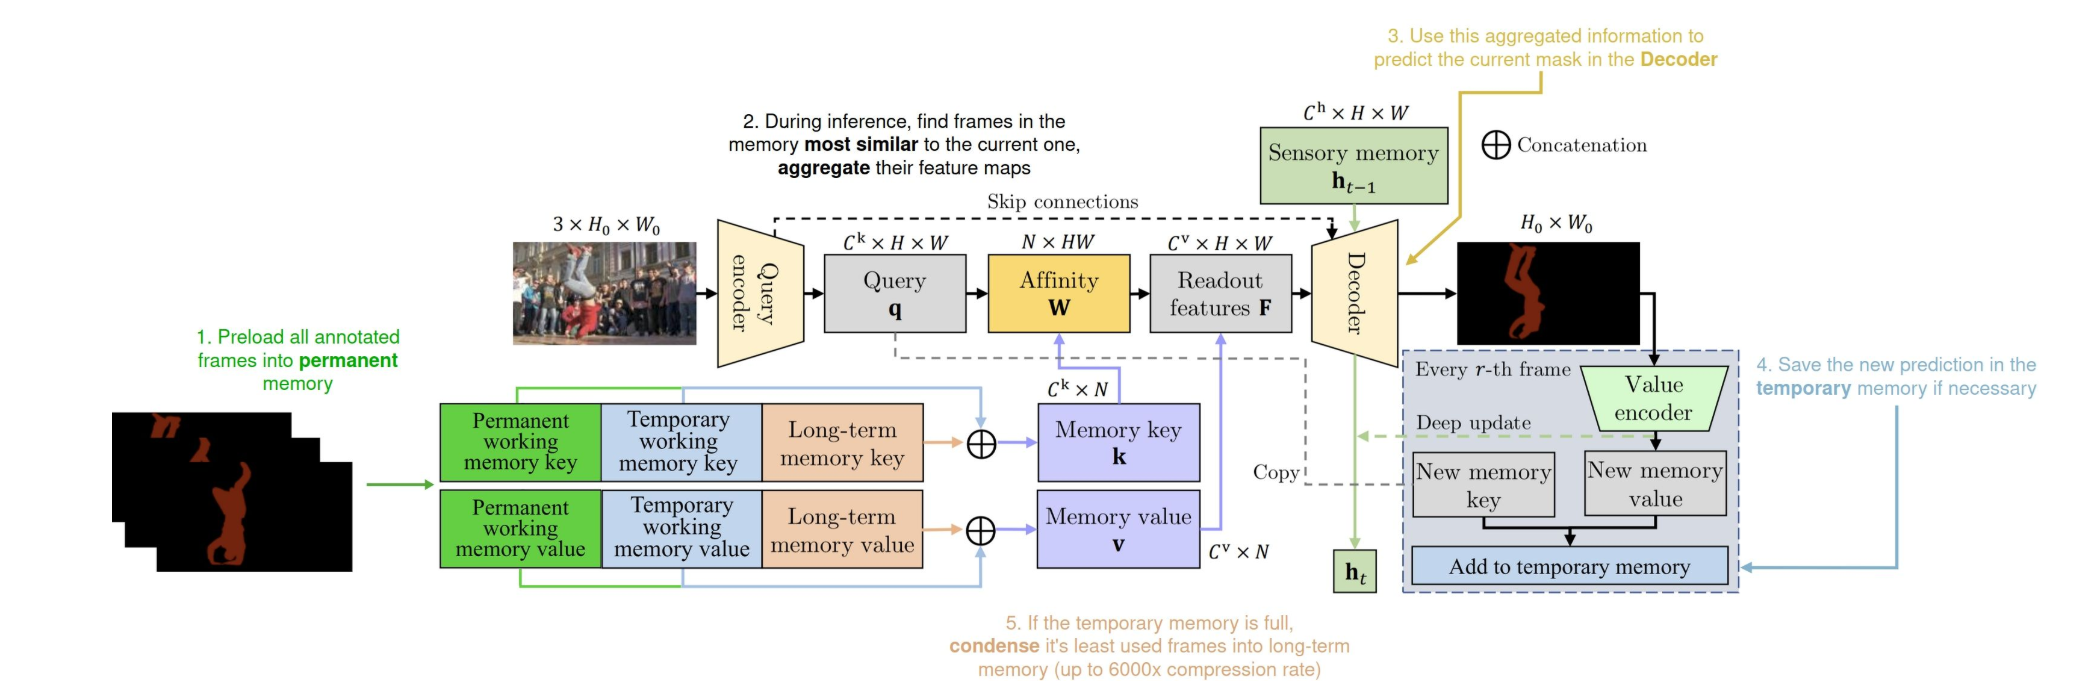
Source: XMem++: Production-level Video Segmentation From Few Annotated Frames, https://max810.github.io/xmem2-project-page/
과거 프레임의 정보를 여러 종류의 memory에 저장해두고, 현재 프레임의 feature와 pixel-level matching을 해서 target object를 찾는 방식입니다. 원래 XMem은 인간 기억 모델에서 영감을 받아 sensory memory, working memory, long-term memory를 두고, 긴 영상에서도 memory가 무한히 커지지 않도록 중요한 정보를 장기 memory로 압축·유지
-
Cutie
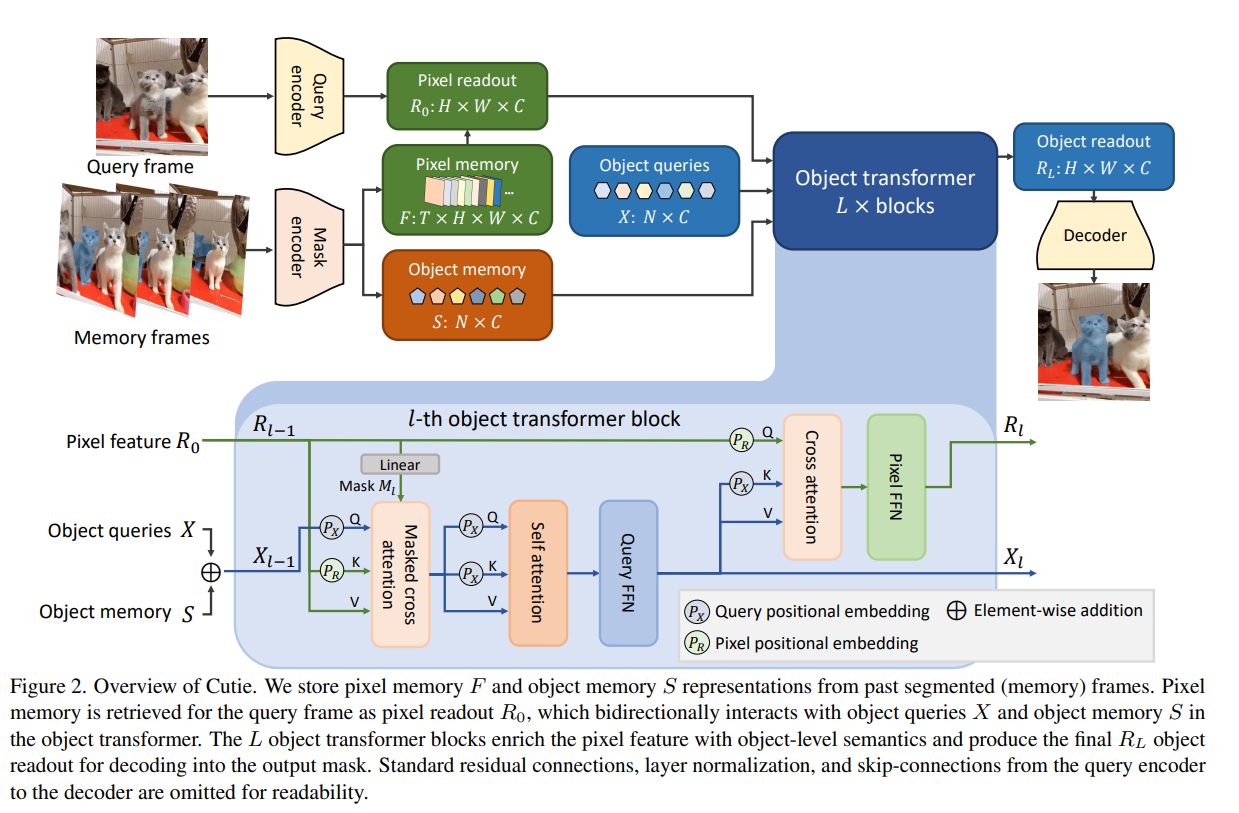
Source: Putting the Object Back into Video Object Segmentation, https://arxiv.org/abs/2310.12982
pixel-level matching의 약점을 지적하는데 비슷하게 생긴 distractor가 많으면 pixel끼리만 비교해서는 target identity가 헷갈릴 수 있다는 것
⇒ Cutie는 object-level representation을 추가합니다. 작은 수의 object queries가 target object 전체를 요약하고, 이 object query가 pixel-level feature와 반복적으로 상호작용 ⇒ query-based object transformer
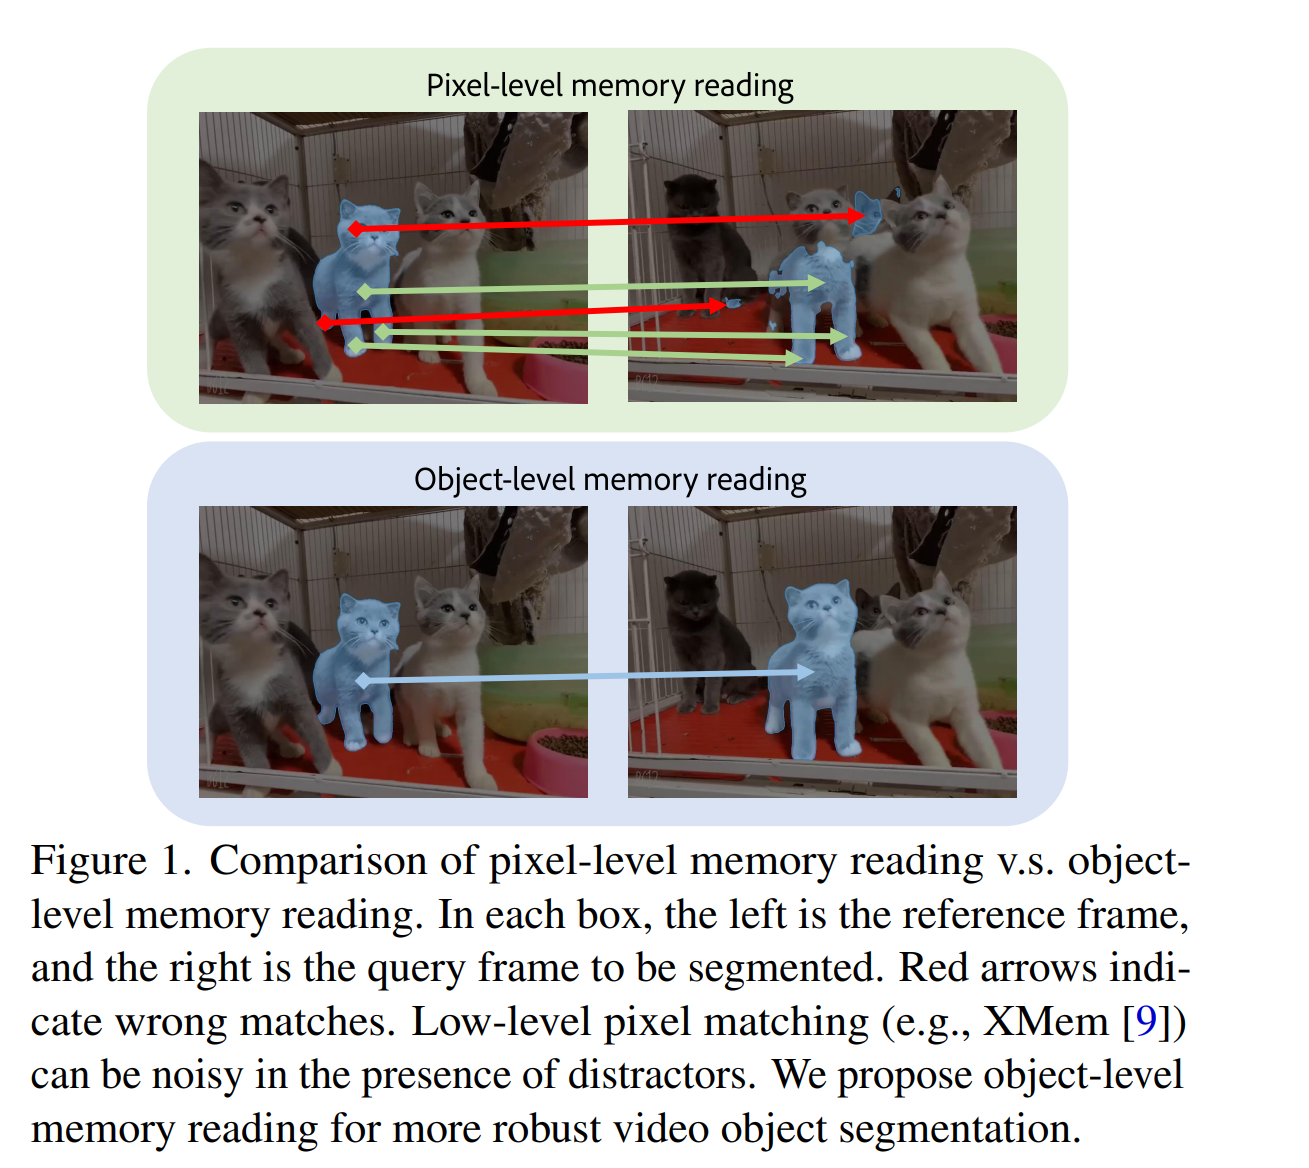
XMem++ Cutie 핵심 아이디어 여러 종류의 pixel memory pixel memory + object-level query Memory matching pixel ↔ pixel pixel matching + object-level reasoning 강점 긴 영상, 여러 annotated frame distractor/occlusion이 많은 복잡한 장면 특징 permanent/working/long-term memory query-based object transformer 해결하려는 문제 memory 효율과 annotation 비용 pixel matching noise와 object confusion
5.1.2. Semi-supervised VOS
SAM 2가 interactive setting에서만 강한 게 아니라, 기존의 고전적인 VOS protocol에서도 전문 tracker들을 이긴다.
Source: Original Document
5.1.3. Image Segmentation
SAM 2가 video 기능을 넣으면서 원래 SAM의 image segmentation 성능을 희생했는가
⇒ video capability를 추가했는데도 image segmentation 성능이 떨어지지 않았고, 오히려 개선되었다.
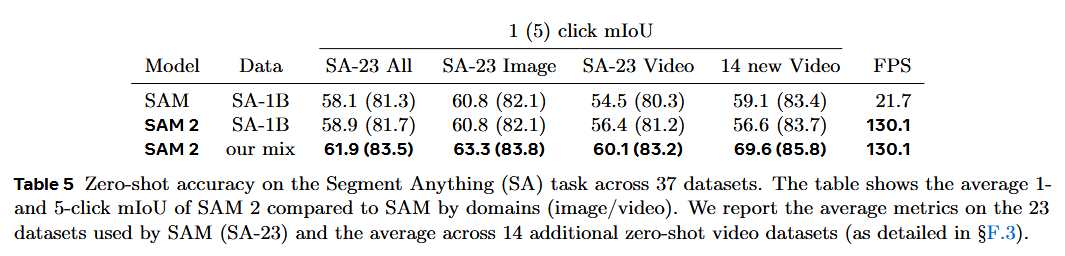
Source: Original Document
5.2. Comparison to state-of-the-art in semi-supervised VOS
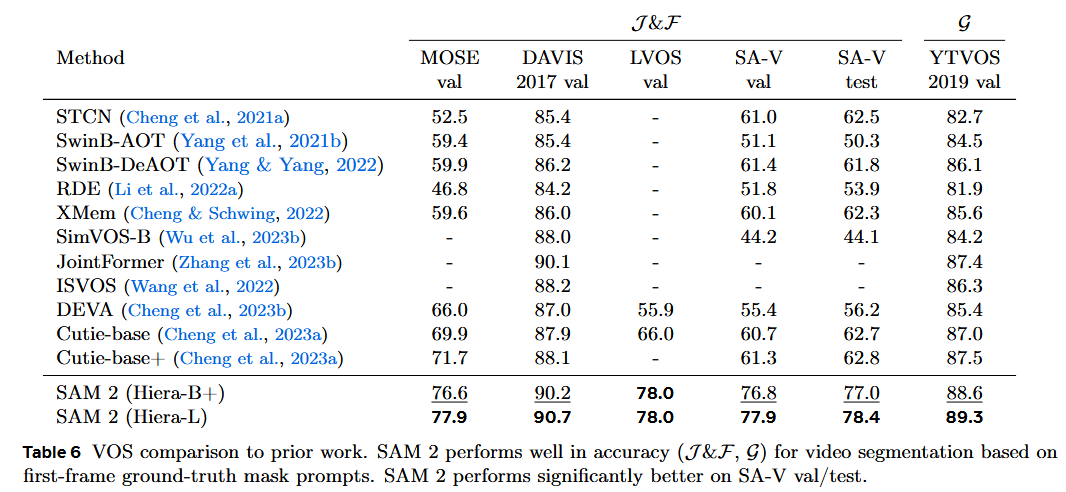
Source: Original Document
❓ 는 어떤 지표인가? : YouTube-VOS의 region-and-contour score, 즉 seen/unseen category 성능을 함께 반영한 최종 VOS 지표
YouTube-VOS에서는 객체 category를 두 그룹으로 나눈다.
Seen categories: training set에서 본 category
Unseen categories: training set에서 보지 못한 category
각 그룹에서 다시 와 를 계산
: seen category의 region IoU
: seen category의 boundary F-measure
: unseen category의 region IoU
: unseen category의 boundary F-measure
그리고 최종 는 이 네 값을 평균한다.
학습 때 본 객체와 처음 보는 객체 모두에 대해 영역과 경계를 얼마나 잘 segmentation하는지를 종합적으로 평가
6. Limitation
-
identity를 제대로 해결한 모델은 아니다
The model may fail to segment objects across shot changes and can lose track of or confuse objects in crowded scenes, after long occlusions or in extended videos.
-
섬세한 segmentation에 대해서는 여전히 어려움을 겪는다
SAM 2 also struggles with accurately tracking objects with very thin or fine details especially when they are fast-moving
-
multi-object interaction을 거의 모델링하지 않는다
While SAM 2 can track multiple objects in a video simultaneously, SAM 2 processes each object separately, utilizing only shared per-frame embeddings without inter-object communication
-
여전히 human annotation에 의존적이다
Our data engine relies on human annotators to verify masklet quality and select frames that require correction. Future developments could include automating this process to enhance efficiency.
-
long-term understanding과는 거리가 멀다. 그렇기에 memory가 있다고 해서 video semantics를 이해하는 것은 아니다.
SAM 2의 memory는 대체로 “이 object가 과거에 어떤 visual/spatial feature를 가졌는가?” 를 유지하는 장치이지 “이 객체가 3분 전에 무엇을 했고 다른 객체와 어떤 관계였는가?”를 이해하지는 않는다.