Paper Information
Title: VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training
Authors: Zhan Tong, Yibing Song, Jue Wang, Limin Wang
Affiliation: State Key Laboratory for Novel Software Technology, Nanjing University; Tencent AI Lab; Shanghai AI Lab
arXiv ID: arXiv:2203.12602 [cs.CV]
Topic: Self-Supervised Video Pre-Training, Masked Autoencoders, Video Representation Learning, Video Action Recognition, Vision Transformer, Spatiotemporal Modeling
Venue: Advances in Neural Information Processing Systems 35 (NeurIPS 2022), Main Conference Track
Pages: 25 pages (arXiv v3, including supplementary material)
1. One-line Summary
VideoMAE는 plain ViT에 high-ratio tube masking을 적용해 비디오 reconstruction task를 어렵게 만들고, 작은 데이터셋에서도 강한 video representation을 학습할 수 있음을 보였으며, SSVP에서는 데이터 양보다 target domain과의 일치도가 더 중요할 수 있음을 제시했다.
2. Problem
The inductive bias is effectively reduced via this flexible attention mechanism.
효과적으로 ViT를 학습하기 위해서는 보통 큰 규모의 supervised dataset이 필요하게 된다.
Video Transformers는 보통 image 기반 transformer에 비롯되는 경우가 많고 ImageNet과 같은 큰 규모의 image data로부터 사전 학습된 모델에 의존적인 경우가 많다.
또한 이전 연구들에서는 from scratch로 사전 학습 없이 video transformer를 바로 학습하려는 시도가 있었지만 strong inductive bias를 더한 MViT를 제외하고는 불만족스러운 성능이 나왔다.
그러므로 video transformer는 보통 image 기반의 모델에 잘연스럽게 편향적인 경향이 있고 _어떻게 하면 바닐라 버전 vision transformer를 추가적인 사전학습 모델이나 이미지 데이터 없이 영상 데이터에 효율적이고 효과적으로 학습시킬 것인가_는 아직까지 해결되지 않음
기존의 영상 데이터셋의 경우 이미지 데이터셋과 비교했을때 상대적으로 작은데, 이 점이 video tansformer가 사전 학습 하지 않고 학습 시키는 것을 더 어렵게 만든다.
⇒ 그런 와중 self-supervised learning 전략이 등장했는데 이건 learned representations가 supervised learning을 통해 학습 한 것 보다 donwstream task로 전이 됨에 있어 더 좋은 성능을 보여주었다.
> It is expected that this **self-supervised learning paradigm** can provide a promising solution to address the challenge of training video transformers.⇒ self-supervised video pre-training method를 활용한 Video Masked Autoencoder를 만들겠다. 이전 image-based MAE에 비해 시간축이 추가되었기 때문에 생기는 문제들이 존재한다.
1. (**Temporal Redundancy**) 비디오가 시간적으로 매우 촘촘한 간격으로 프레임을 기록한다 그렇기 때문에 의미 또한 시간에 따라 느리게 변화한다.
    > video frames are often **densely captured**, and their semantics varies slowly in time

    →이런 특징은 고수준 이해 측면에서 시공간적으로 이웃하는 것들로부터 missing pixel를 복구할 가능성이 커짐

2. (**Information Leakage**) 영상은 static appearance의 시간적 흐름에 따른 변화로 받아들여질 수 있고 이 점에서 프레임간의 관계성이 있을 수 있다. → masked spatiotemporal content re-occurrence
Related Work
Video representation learning
Supervised learning method의 경우 보통 image backbone에 의지한다. video encoder backbone은 처음에 upservised form의 image data를 통해 사전학습한 다음 human action 분류를 위한 video dataset에 fine-tuning을 진행한다. (2 Step)
💡 semi-supervised learning이란? 라벨이 있는 학습 샘플의 representation을 이용해서, 라벨이 없는 샘플에도 학습에 쓸 수 있는 supervision signal을 만들어준다.
Labeled videos→representation→unlabeled videos에 pseudo supervision 제공
supervised나 semi-supervised 의 representation은 보통 top-down training paradigm을 활용하는데 영상 데이터 구조 자체를 탐색하는데 있어서는 효과적이지 않다.
Top-down paradigm이란?
사람이 미리 정의한 라벨이나 과제 목표를 기준으로, 그 목표를 잘 맞추도록 representation을 학습하는 방식
→ 모델은 데이터 자체의 모든 구조를 탐색하기보다는 주어진 label space에 유용한 특징을 우선적으로 학습하게 됩니다.
반면 self-supervised learning의 경우 temporal information에 대한 사전 지식은 SSVP를 위한 pretext task를 디자인하면서 탐색된다. ⇒ contrastive learning 역시 visual representation을 효과적으로 배우는 한 종류
⇒ 그런데 이 경우 data augmentation과 large batch 사이즈에 심하게 의존적이다.물론 이전에도 label 없는 self-supservised learning for video는 존재했다. CNN이나 LSTM backbone을 이용해 비디오의 일부 또는 미래 프레임을 복원 및 예측하는 방법이 그 예이다.
비디오를 토큰이나 픽셀 단위 sequence로 보고 앞부분을 보고 뒤의 내용을 순차적으로 생성하는 방법 또한 그 예가 될 수 있다.
그래서 저자들은 최근 이미지에서 성공한 MAE를 ViT 기반 비디오 학습에 적용하고, 이를 작은 데이터에서도 효과적으로 학습되는 SSVP 방법으로 만들겠다라고 말한다.
Masked visual modeling
Masked visual modeling has been proposed to learn effective visual representations based on the simple pipeline of masking and reconstruction
3. Method
temporal redundancy와 information leakage와 같은 문제를 방지하고 video masked modeling을 더 효과적으로 하기 위해 extremely high ratio를 가진 tube masking을 제시한다.
-
First, due to temporal redundancy, we use an extremely high masking ratio to drop the cubes from the downsampled clips
⇒ pretraining 성능을 올릴 뿐만 아니라 asummetric encoder-decoder 구조로부터 얻을 수 있는 연산비용 측면에서의 이득도 존재한다.
-
To consider temporal correlation, we devise a simple yet effective tube masking strategy, which turns out to be helpful in relieving the risk of information leakage for cubes with no or negligible motion during reconstruction
Vanilla ViT backbone?
: 3D CNN, CNN + Transformer hybrid, optical flow branch, 특수한 temporal attention module 같은 구조를 적극적으로 추가하지 않는다..
→ 복잡한 video-specific backbone을 새로 설계하지 않고도 단순한 ViT로 좋은 성능을 얻었다.
Without extra data?
: Kinetics-400 pretraining → UCF101 fine-tuning처럼 큰 규모의 데이터셋을 활용해서 사전학습하는 것이 아니라
UCF101 unlabeled videos로 VideoMAE pretraining→UCF101 labels로 fine-tuning처럼 하나의 데이터셋으로 학습과 fine-tuning을 진행하자라는 의도
⇒ MAE식 self-supervised pre-training을 쓰면 작은 video dataset 자체만 가지고도 ViT를 효과적으로 학습시킬 수 있다
3.1. Revisiting Image Masked Autoencoders
ImageMAE의 경우 입력 이미지를 로 밭고 겹침 없이 16 by 16으로 패치를 생성한다음 각각의 패치를 token embedding을 통해 representation을 구한다.
그런뒤 높은 masking ratio를 적용해 임의로 마스크된 패치를 생성하고마스킹되지 않은 것만 encoder에 넣는다. 마지막으로 얇은 디코더가 인코더가 내놓은 representation을 보고 learnable mask tokens를 다시 이미지로 생성한다.
Loss Function은 mean squared error (MSE)를 사용하는데 normalized masked tokens와 reconstructed ones in the pixel space를 활용한다.
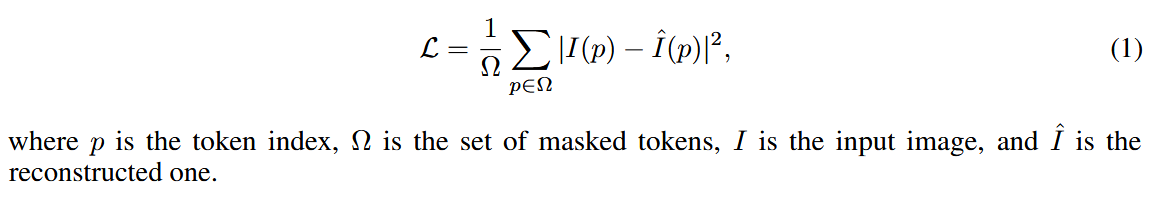
Source: Original Document
3.2. Characteristics of Video Data
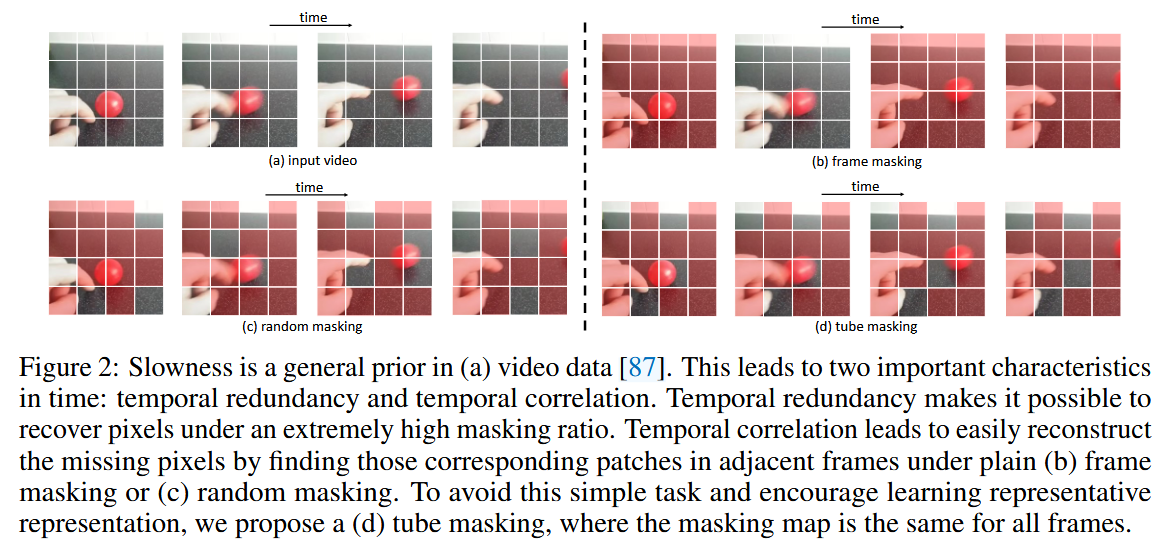
정적 이미지에 비해 영상 데이터는 temporal reltaion을 갖는다. 그리고 그로 인해 아래와 같은 이미지와는 차별되는 특성이 생긴다.
Source: Original Document
-
Temporal redundancy
영상 내에서 의미는 시간축에서 매우 천천히 변화한다. 그로인해 연속되는 프레임들이 매우 중복이 있고 의미가 크게 다르지 않았다.
⇒ 이 특성으로 인해 아래의 두가지 문제가 확인되었다.
-
사전학습 단계에서 원본의 temporal frame rate를 유지하는건 효율적이지 않다
⇒ VideoMAE는 이 특성을 고려해서 원래 frame rate를 유지하면 정적이고 느린 움직임에 편향될 수 있으므로 temporal downsampling을 적용한다
-
temporal redundancy로 인해 motion representation이 흐릿해진다
⇒ 그로 인해 ImageMAE와 같은 마스킹 비율을 활용한다면 encoder의 motion represnetation에 대한 성능이 떨어질 수 있다.
-
-
Temporal correlation
영상은 일종의 정적 appearnace가 시간축을 기점으로 확장된 걸로 볼 수 있고 그렇기에 인접하는 프레임간의 내재된 관계성이 존재할 수있다
⇒ Information leakage를 유발할 수 있는 원인이 되고 encoder가 high-level inofmration이 아닌 low-level temporal correspondence를 학습할 가능성이 있다.
⇒ 그렇기에 VideoMAE에서는 기존의 마스킹 전략보다 더 어렵고 시공간적 구조 학습에 효과적인 과제를 제시한다.
3.3. Experiments
3.3.1. Datasets
- Kinetics-400 : 10초의 길이를 가진 400개의 클래스로 분류된 240K개의 학습 영상과 20K개의 평가 영상이 있다.
- Something-Something V2: 169K개의 학습 영상과 20K개의 평가 영상이 존재한다. 174개의 움직임 중심의 action class가 존재한다.
→ Kinetics와 SSv2 이 두 대규모 영상 데이터 셋은 action recognition에서 다른 시각적 단서를 얻느데 집중한다.
- UCF101: 9.5K개의 학습 데이터와 3.5K개의 평가 데이터를 가지고 있다.
- HMDB51: 3.5K개의 학습 데이터와 1.5K개의 평가 데이터를 가지고 있다.
→ 상대적으로 규모가 작은 이 영상 데이터셋은 small dataset에 대한 large ViT model이 학습하는게 더 어렵기에 VideoMAE의 효과를 검증하기 위해 활용한다.
- AVA: 사람의 행동에 대해 spatiotemporal localization을 위한 데이터셋으로 211K개의 학습 데이터와 57K개의 평가 데이터로 구성되어있는데 이를 통해 VideoMAE의 전이학습을 평가할 수 있게 된다.
3.3.2. Ablation Studies
Source: Original Documents
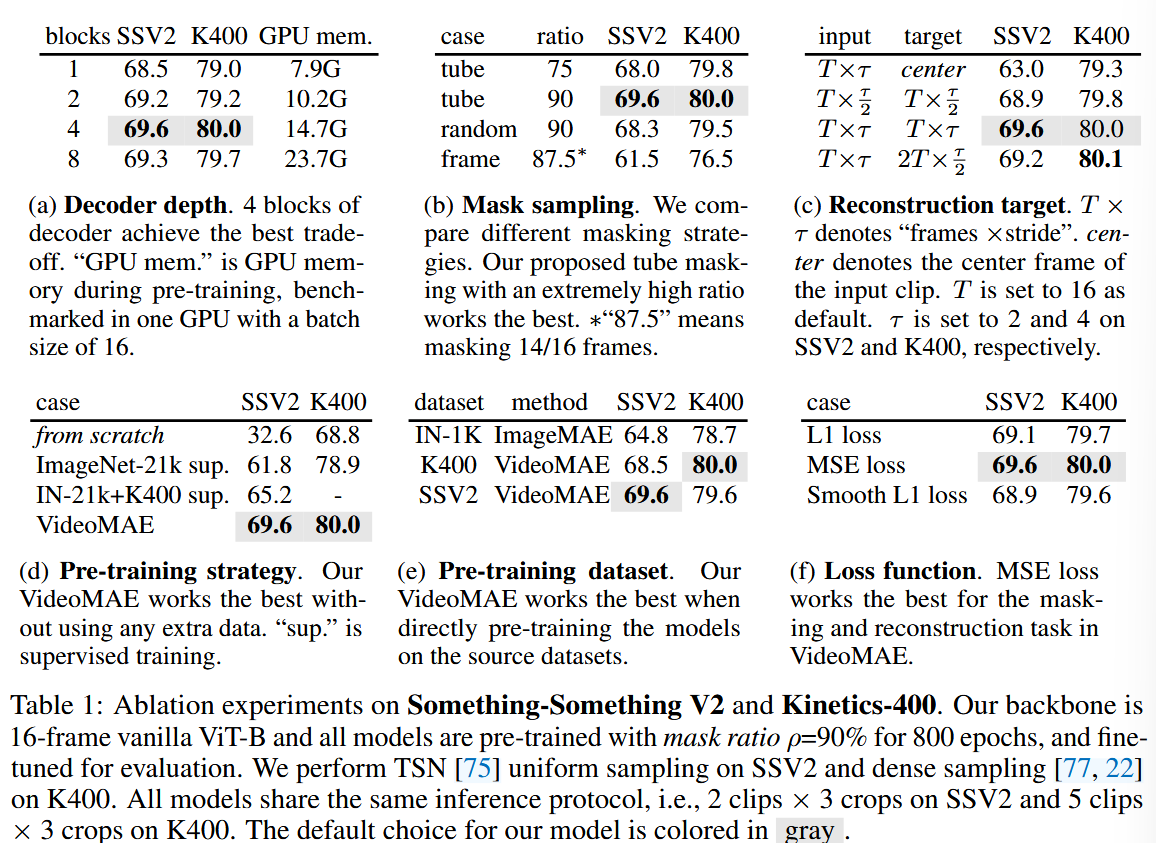
실험 구조는 기본적으로 16-frame을 입력으로 받는 ViT-B를 SSv2 와 K400에 학습시킨 것으로 ablation study를 진행했다.
Fine-tuning의 경우 SSv2에 대해서는 TSN uniform sampling을 진행했고 K400에 대해서는 dense sampling을 진행했다.
| 방식 | sampling 방식 | 특징 |
|---|---|---|
| TSN uniform | 영상 전체를 균등 분할 후 각 구간에서 샘플링 | 전체 temporal coverage가 큼 |
| Dense sampling | 특정 구간에서 연속적/촘촘하게 샘플링 | local motion을 자세히 봄 |
모든 델은 동일한 추론 프로토콜을 공유하는데 SSv2에 대해서는 로, K400에 대해서는 에 대해서는 로 추론을 진행하였다.
Decoder Designs
Source: Original Document - table 1
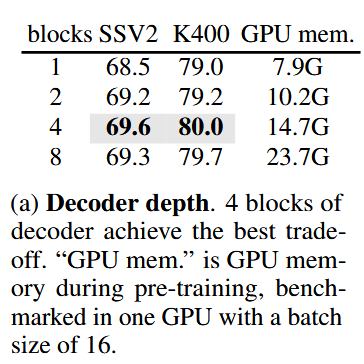
Image MAE와 마찬가지로 VideoMAE 역시 경량화된 디코더가 핵심 요소이다. Depths에 따라 실험을 진행했고 shallow decoder가 GPU memory consumption을 줄이는데에 더 유리했던 반면,
ImageMAE와 달리 지나치게 shallow한 decoder는 VideoMAE 성능을 떨어뜨렸으며, 4-block decoder가 성능과 메모리 사용량 사이에서 가장 좋은 trade-off를 보였다. 8-block까지 늘린다고 추가 향상이 나타나지는 않았다.
Masking strategy
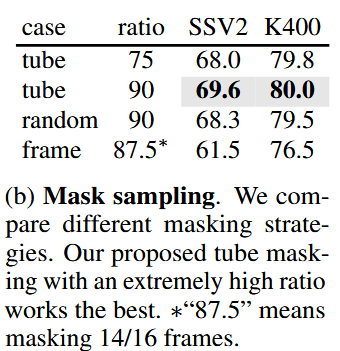
Source: Original Document - table 1
tube masking 전략에서 마스킹 비율을 75%에서 90%로 올리면 SSv2에서 성능이 68.0%에서 69.6%로 증가하게 된다
⇒ 영상은 높은 temporal redundancy를 가지므로, masking ratio가 너무 낮으면 남아 있는 정보만으로 reconstruction이 지나치게 쉬울 수 있다. 따라서 높은 masking ratio를 적용함으로써 reconstruction task의 난이도를 높이는 것이 representation learning에 도움이 된다.
⇒ 아 극도로 높은 마스킹 비율에서 tube masking 전략이 다른 완전 무작위 마스킹과 프레임 마스킹 전략에 비해 좋은 성능을 보여주는구나하고 알게 된다.
- SSV2: 행동의 시간적 변화와 object interaction이 중요
- K400: 상대적으로 stationary하고 scene-related한 영상이 많음
따라서 SSV2에서는 temporal modeling의 품질이 성능에 큰 영향을 주지만, K400에서는 배경이나 appearance만으로도 행동을 어느 정도 구분할 수 있어서 tube masking의 이점이 덜 크게 나타난다
Reconstruction target
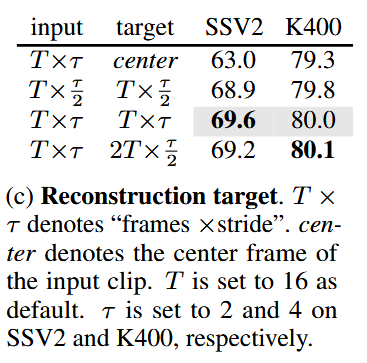
Source: Original Document - table 1
만약 목표의 중장에 위치한 프레임만 샘플링한다면 stride를 적용해 샘플림한 것에 비해 성능이 떨어지고 특히 SSv2에서 더 떨어진다.
실험 A — Reconstruction target
입력은 그대로 인데 reconstruction target을 전체 downsampled clip이 아니라 center frame 하나만 사용
→ 그 결과 SSV2가 $69.6 \rightarrow 63.0$으로 크게 떨어진다.실험 B — Sampling stride
기본 stride 대신 더 촘촘한 를 사용하면 로 떨어니다.
실험 C — 더 많은 frame reconstruction
개 downsampled frame을 입력으로 받아 frame을 복원하도록 해도 SSV2는 로 약간 떨어집니다.
그래서 최종적으로 입력으로 사용한 downsampled -frame clip 자체를 reconstruction target으로 사용하는 가장 단순한 방법을 채택
적절한 temporal sampling interval이 필요하며, 너무 촘촘하게 sampling하면 중복된 정보가 많아져 VideoMAE 학습에 오히려 불리할 수 있다
Pre-training strategy
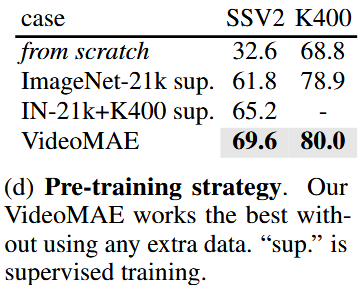
Source: Original Document - table 1
사전학습 없이 ViT-B를 바로 supervised training하면 특히 SSV2에서 32.6%로, 여러 pre-training 전략에 비해 상당히 낮은 성능을 보인다.
IN-21K에 학습시키거나 IN-21K와 K400에 학습시켰을때에는 훨씬 성능이 좋게 나온다.
하지만 이런 IN-21K나 K400과 같은 외부 데이터 없이 순수하에 SSv2와 K400에 VideoMAE 형태로 학습시킨게 성능이 가장 잘 나왔다.
| 실험 | 시작 상태 | Pre-training | Fine-tuning |
|---|---|---|---|
| Scratch | Random init | 없음 | SSV2/K400 label로 바로 학습 |
| ImageNet-21K | pretrained | ImageNet-21K supervised | SSV2/K400 |
| ImageNet-21K + K400 | pretrained | ImageNet-21K → K400 supervised | SSV2 |
| VideoMAE | Random init | target dataset 자체에서 self-supervised MAE | target dataset supervised |
Pre-training dataset
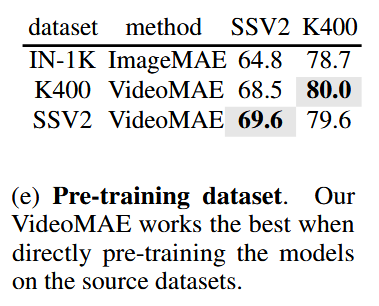
Source: Original Document - table 1
- 실험 방법
- ImageMAE 비교군
- ViT-B를 ImageNet-1K에서 ImageMAE 방식으로 1600 epoch self-supervised pre-training
- 이미지용 2D patch embedding을 비디오용 3D cube embedding으로 inflate
- 이후 SSV2나 K400 같은 target video dataset에서 fine-tuning
- VideoMAE 비교군
- K400 또는 SSV2 같은 video dataset에서 VideoMAE 방식으로 self-supervised pre-training
- 이후 target dataset에서 supervised fine-tuning
- ImageMAE 비교군
- 결과
- ImageNet-1K에서 사전학습한 ImageMAE도 from-scratch 학습보다 성능이 크게 좋았다.
- 하지만 video dataset에서 VideoMAE로 사전학습한 모델이 ImageMAE보다 더 좋은 성능을 보였다.
- 특히 target dataset과 동일한 데이터셋에서 VideoMAE pre-training한 경우가 가장 좋은 결과를 보였다.
4. Key Idea
data-efficient learners for self-supervised video pre-training (SSVP)
customized video tube masking with an extremely high ratio.
⇒This simple design makes video reconstruction a more challenging and meaningful self-supervision task
⇒ encouraging extracting more effective video representations during the pre-training process
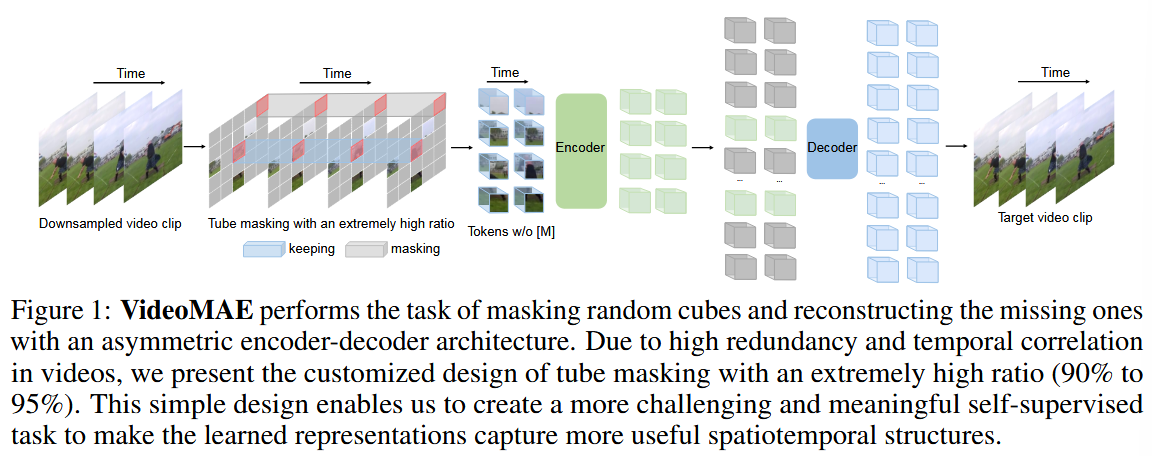
Source: Original Document
-
VideoMAE가 원본 비디오를 그대로 Transformer에 넣는 것이 아니라, 먼저 시간축으로 일부 프레임을 샘플링한 뒤 (Downsampled frames), 여러 프레임에 걸친 작은 3차원 블록을 하나의 token으로 변환한다
ViT VideoMAE 2D image 3D video 16×16 patch 2×16×16 cube spatial token spatiotemporal token H×W 분할 T×H×W 분할 -
비대칭적인 인코더 디코더 구조로 MAE 사전학습을 진행하는데 tube masking을 높은 비율로 적용한다. + Vanilla ViT를 joint space-time attention 구조로 backbone으로서 활용한다.
-
Vanilla는 무슨 의미인가?
: 별도의 video-specific Transformer 구조를 복잡하게 추가하지 않고, 기본 ViT의 Transformer block을 거의 그대로 사용한다
표현 의미 vanilla ViT 기본적인 ViT 구조를 사용한다는 architecture 이야기 joint space-time attention 공간·시간 token을 분리하지 않고 한 번에 self-attention한다는 이야기 without extra data Kinetics 같은 외부 데이터셋을 사용하지 않았다는 data 이야기 trained from scratch pretrained weight 없이 supervised task를 처음부터 학습한다는 training 이야기 단계 무엇을 줄이나 방법 Frame downsampling temporal redundancy 원본 frame 일부를 아예 사용하지 않음 Cube embedding spatial + temporal redundancy 남은 local pixels/frames를 하나의 token으로 압축 High-ratio masking redundancy를 이용해 학습 난이도 증가 token의 90–95%를 숨김 -
4.1. Temporal Downsampling
인접한 프레임간의 Temporal redundancy를 해결하기 위해 더 효과적인 영상 사전학습을 위하여 strided temporal sampling전략을 활용했다.
- 먼저 원본 영상에서
t개의 연속되는 프레임을 가진 영상 클립을 임의추출한다.- 해당 클립에서
T개의 프레임을 추출해 영상을 압축한다. (프레임당 의 픽셀을 가지고 있음) stride 는 Kinetics 에서는 4로, SS에서는 2로 설정되었다.
4.2. Cube Embedding
Joint space-time cube embedding을 활용했는데 각 큐브의 사이즈는 한 토큰 임베딩으로서 의 픽셀을 가지고 있다.)
→ 따라서 ImageMAE라면 2개의 토큰으로 나누어질 것을 VideoMAE에서는 한개로 합쳐서 (큐브처럼 직육면체로) 활용하는 것이다.
⇒ 총 개의 3D Token을 얻을 수 있고 각 토큰은 channel dimension D에 매핑된다.
이 방식이 입력값의 시공간적 차원을 감소 시키고 영상의 spatiotemporal redundancy를 해소한다.
⇒ spatiotemporal tokenization + dimensionality reduction
4.3. Tube Masking with Extremely High Ratios
VideoMAE의 masking 전략은 영상의 두 가지 특성인 Temporal Redundancy와 Temporal Correlation을 고려하여 설계되었다.
4.3.1. Temporal Redundancy 측면 — Extremely High Masking Ratio
영상은 이미지와 달리 인접한 frame 사이에 매우 유사한 정보가 반복되기 때문에 높은 temporal redundancy를 가진다.
즉 영상은 이미지에 비해 단위 token당 새로운 정보의 밀도가 낮다.
따라서 ImageMAE의 약 75%보다 훨씬 높은 90~95%의 masking ratio를 적용해도 reconstruction이 가능하다.
오히려 masking ratio가 낮으면 보이는 token이 너무 많기 때문에 masked cube의 내용을 주변 spatial/temporal token으로 쉽게 추측할 수 있다.
따라서 높은 masking ratio는 Information Leakage 감소→Reconstruction Difficulty 증가를 통해 video reconstruction을 보다 의미 있는 self-supervised pre-training task로 만든다.
4.3.2. Temporal Correlation 측면 — Tube Masking
하지만 90~95%를 masking하는 것만으로도 충분하지 않다.
영상에서는 동일한 위치의 객체가 여러 frame에 걸쳐 비슷하게 존재하기 때문에 강한 temporal correlation이 존재한다.
예를 들어 일반적인 frame별 random masking을 사용한다고 가정하면:
같은 spatial location

Frame 1       visible
Frame 2       MASK
Frame 3       visible
Frame 4       visible
Frame 2의 cube가 가려졌더라도 Frame 1이나 Frame 3의 동일한 spatial position을 보면 거의 그대로 복원할 수 있다.
특히 해당 영역의 motion이 거의 없다면
이므로 reconstruction task가 지나치게 쉬워진다.
이것이 저자들이 말하는 temporal information leakage이다.
Temporal Tube Masking
이를 해결하기 위해 VideoMAE는 같은 spatial 위치를 모든 시간축에서 함께 masking한다.
즉 모든 frame이 동일한 spatial mask map을 공유한다.
여기서 ·는 특정 시간 t 하나가 아니라 전체 temporal axis를 의미한다. 따라서 어떤 (x,y) 위치가 mask로 선택되면:
동일 spatial location

Frame 1       MASK
Frame 2       MASK
Frame 3       MASK
Frame 4       MASK
   ⋮           ⋮
처럼 해당 위치가 모든 frame에서 가려진다. 즉, 같은 위치의 temporal neighbor까지 모두 제거된다.
4.4. Backbone: joint space-time attention
높은 마스킹 비율로 인해 인코더에 들어오는 입력값은 더 적어진다. ⇒ 그렇기에 남은 토큰으로 고수준의 시공간적 정보를 얻기 위해서 Vanilla ViT backbone 을 활용해 joint- space-time attention 전략을 채택했다.
💡 Joint space-time attention은 모든 spatiotemporal token 사이에서 attention을 수행하기 때문에 quadratic computational cost가 크다. 그러나 VideoMAE는 90%가량의 token을 masking하고 visible token만 encoder에 입력하는 방식으로 계산량을 줄여 ImageMAE에서의 사례와 달리 계산 부담을 줄일 수 있었다.
To better capture high-level spatio-temporal information in the remaining tokens, we use the vanilla ViT backbone [20] and adopt the joint space-time attention
5. Result
An extremely high proportion of masking ratio (i.e., 90% to 95%) still yields favorable performance for VideoMAE
⇒ The temporally redundant video content enables higher masking ratio than that of images.
VideoMAE achieves impressive results on very small datasets (i.e., around 3k-4k videos) without using any extra data
⇒ This is partially ascribed to the challenging task of video reconstruction to enforce high-level structure learning
VideoMAE shows that data quality is more important than data quantity for SSVP. Domain shift between pre-training and target datasets is an important factor
Contribution 핵심 1. Architecture Plain ViT + tube masking + 90–95% high masking ratio로 단순한 VideoMAE 구성 2. Learning strategy Masking + reconstruction만으로 strong SSVP 가능, from-scratch와 contrastive learning보다 우수 3. Empirical findings 약 3.5k videos로도 학습 가능하며, domain shift가 있을 때 data quantity보다 data quality가 중요
5.1. VideoMAE: data-efficient learner
이전에도 SSVP는 없는 방법론은 아니었지만 주로 CCNN 기반의 백본에 대해서 진행을 함 (물론 transformer 기반도 시도는 되어왔지만 소수임)
⇒ 정말 VideoMAE가 transformer-based SSVP에서 효과적인 방법론인가?를 확인하기 위해 아래와 같이 비교를 진행함
1. **training from scratch**
    > 저자들은 이 사전 학습 없는 모델 학습을 위해서 _carefully_하게 pre-train ViT-Base를 데이터셋의 학습 셋으로부터 하이퍼파라미터를 조정했다고 한다.

    > 💡 조금 이상했던 표현
    > **Training from scratch:** pretrained weight 없이 randomly initialized ViT-B를 target dataset에서 supervised training.
    >
    > 논문 문장의 “**pre-train ViT-Base**”는 문맥상 “train ViT-Base from scratch”를 의미하는 것으로 보인다.
    >
    > _“ViT는 작은 video dataset에서 from scratch로 학습하기 어렵기 때문에, scratch baseline이 단순히 hyperparameter 설정 실패 때문에 낮게 나오지 않도록 충분히 튜닝했다”_를 의도한 것처럼 보임

2. **pre-trainig with contrastive learning (MoCo v3)**
    > MoCo와 같은 contrastive learning 역시 collapse issue를 피하는 등 MoCo v3 baseline도 허술하게 구현하지 않았다. 원 논문의 학습 방식을 충실히 따르고 collapse까지 신경 써서 제대로 학습한 뒤 VideoMAE와 비교했다.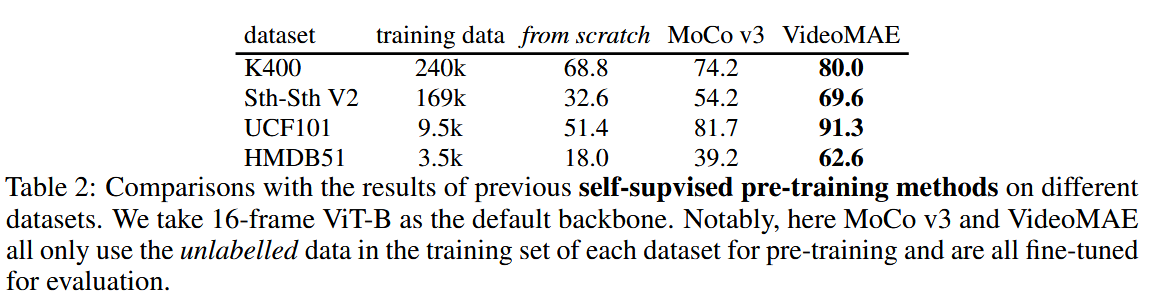
Source: Original Document
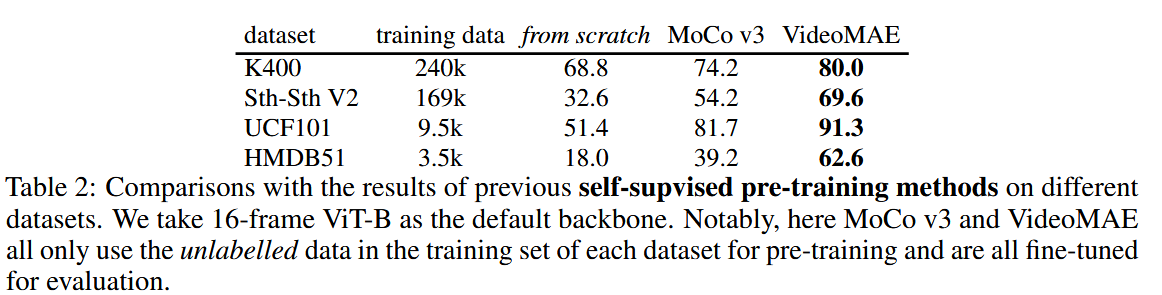
- target dataset에 상관 없이 VideoMAE가 모든 데이터셋에서 가장 좋은 성능을 보여주었다.
- K400과 같이 규모가 큰 데이터셋에서만 성능이 좋았던 것이 아니라 HMDB51과 같이 소규모의 데이터셋에서도 다른 모델에 비교해 훨씬 좋은 성능을 보여주었다.
data-efficient
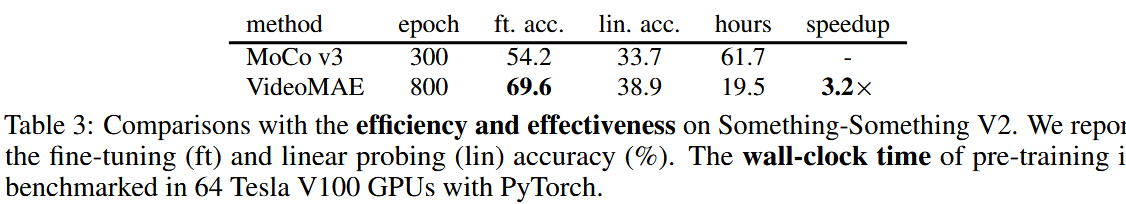
Source: Original Document
- 단순히 성능만 좋은 것이 아니라 학습 시간 면에서도 우월했다.
- 눈에 띄는 점은 빨랐지만 오히려 실행한 epoch 수는 2배 이상 많았다는 것이다 (800 vs. 300)
5.2. High masking ratio
MAE가 처음 제시되었을때의 핵심이 VideoMAE로 이어지는데, 높은 마스킹 비율이다 (심지어 ImageMAE보다도 더 높음)
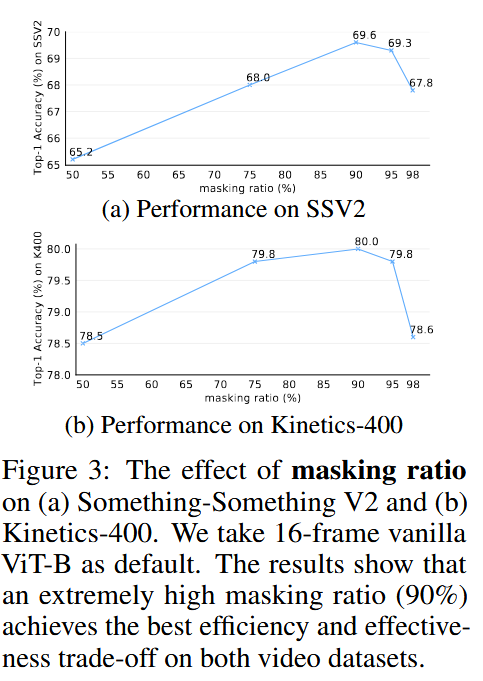
Source: Original Document
SSv2와 K400에 대해서 Video MAE에서 Masking ratio의 영향을 알아보았는데, 둘 다 elbow point가 존재했다. 하지만 놀라운 점은 95%라는 높은 마스킹 비율에도 실험에서 좋은 성능을 보여주었다는 것이다.
→ 이 점이 NLP의 BERT나 Image의 MAE에서 다른 점이다.
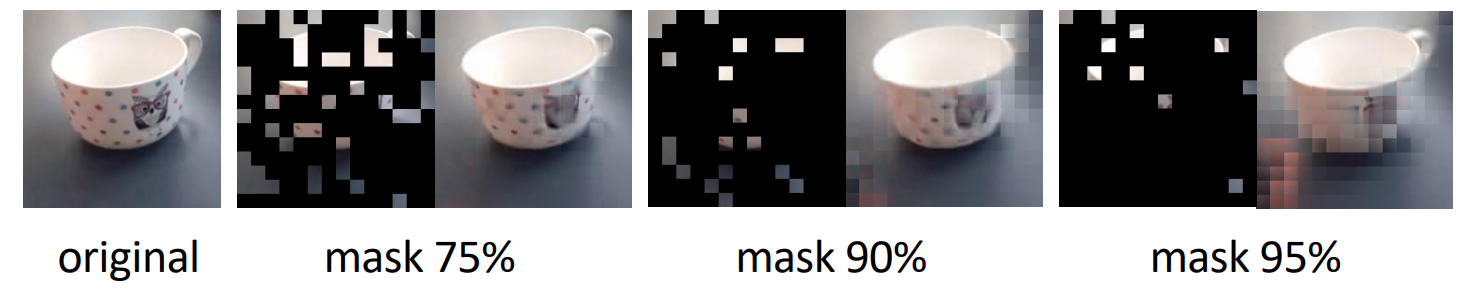
Source: Original Document - Appendix: Table 11
실제로 재구성한 결과물을 보면 95%라는 극단적인 masking에서도 전체적인 appearance와 spatiotemporal structure를 상당 부분 복원한 plausible reconstruction을 만들어냈다.
This implies VideoMAE is able to learn useful representations that capture the holistic spatiotemporal structure in videos.
holistic : 총체적인
5.3. Transfer learning: quality vs. quantity
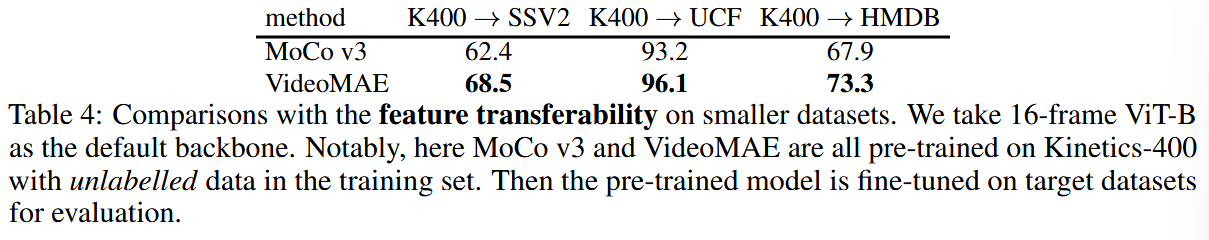
VideoMAE가 representation learning 에서 일반화 능력을 보기 위해 VideoMAE를 K400에 학습시킨후 SSv2, UCF101, HMDB51에 각각 전이학습을 진행했다.
Source: Original Document
Source: Original Document
- MoCo v3에 비해 좋은 성능을 보여주었다 ⇒ contrastive learning방법의 MoCo에 비해 좋은 일반화 성능을 보여준다.
- 하지만 SSv2의 경우 자체적으로 SSv2 → SSv2로 학습시킨 VideoMAE 보다 K400으로 사전학습 시킨 뒤 전이학습을 진행한 VideoMAE가 더 좋지 않은 성능을 보였다 (69.6% → 68.5%)
- UCF101이나 HMDB51을 자체적으로 했을때 보다 K400으로 사전학습한 뒤 전이학습을 진행했을때 성능이 더 좋게 나왔다
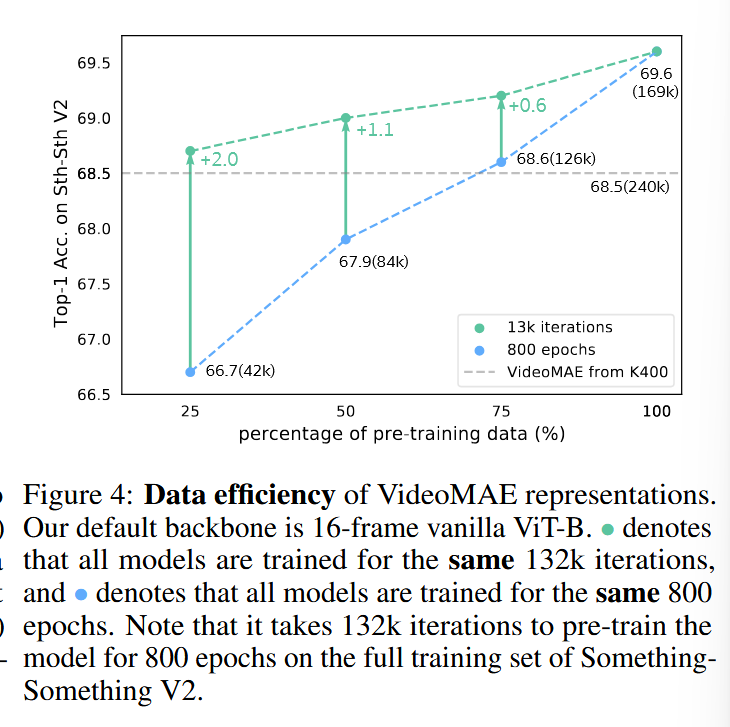
⇒ 그렇다면 SSv2가 Large scale dataset이기 때문에 발생한 일인가?를 아래 두 실험으로 검증했다
1. Pre-training with **the same epochs**
2. Pre-training with **the same time budget**
Source: Original Document
결과
-
사전학습 데이터셋의 사이즈를 줄일때 학습 반복 횟수(iterations)를 늘리는 것은 특히 도움이 된다.
42K개의 SSV2 target-domain 영상이 있어도 Kinetics의 240K개의 영상으로 학습한 것과 동일하거나 더 좋은 성능을 보일 수 있다. (68.7% vs. 68.5%)
-
Domain shift가 사전학습에서 중요한 또 다른 요소이고 SSVP에서 사전학습 용 데이터셋과 학습 대상인 데이터셋이 차이가 있을때 데이터의 질이 데이터의 양보다 더 중요하다라는 결론을 얻어냈다.
⇒ 데이터가 적을때 VideoMAE가 효율적인 학습 방법론이 될 수 있다.
5.4. Transfer learning: downstream action detection
저자들은 K400으로 학습한 VideoMAE를 AVA 데이터셋의 action detection에도 화룡ㅇ할 수 있는지 전이학습을 진행했다.
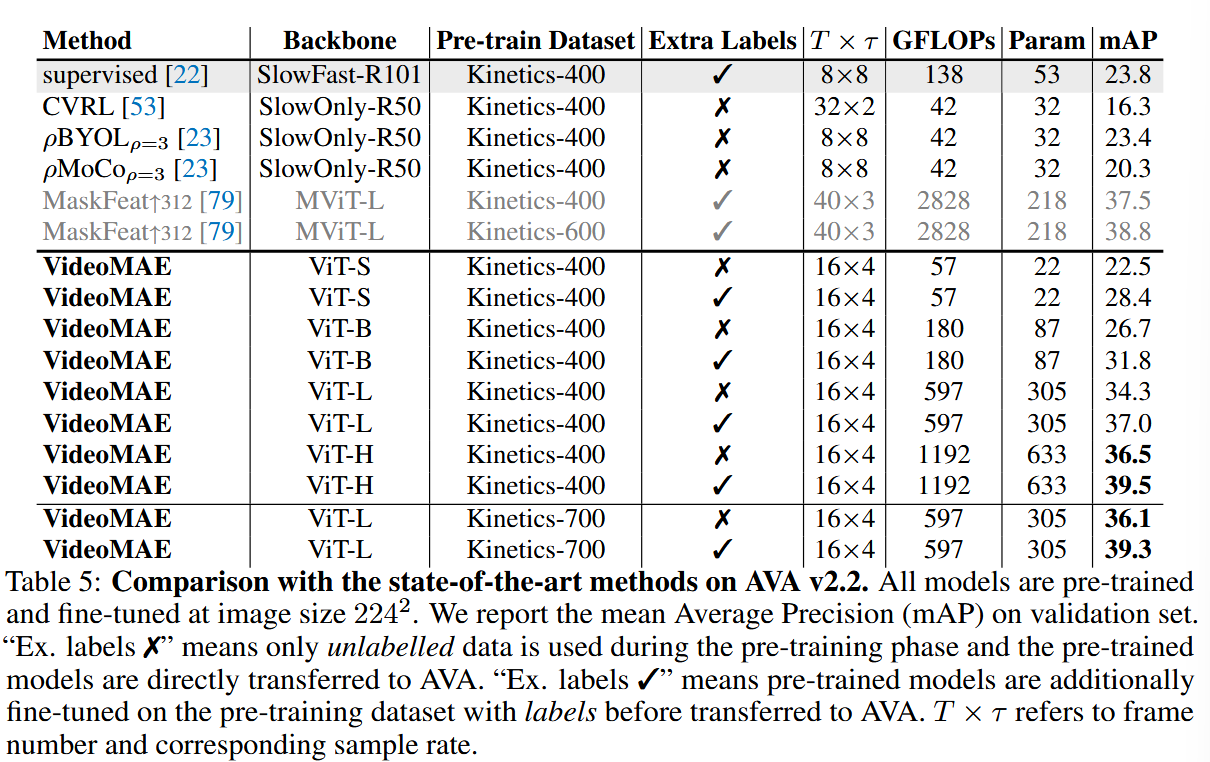
- top 60개의 common classes에 대해서 mean Average Precision (mAP)을 활용해서 평가를 진행했는데 이 지표는 0.5의 threshold를 기준으로 IoU 점수를 반영한 것이다.
Source: Original Document
Self-supervised Learning을 K400에 진행한뒤 vanilla ViT-B는 26.7mAP를 달성했는데 이는 다른 방법론과 비교해서 2/3의 모델보다 뛰어난 성능을 보인거고 이는 VideoMAE의 강한 전이능력을 보여주었다고 할 수 있다.
K400에서 VideoMAE self-supervised pre-training만 수행하고 K400의 action labels를 추가로 사용하지 않은 상태에서도 AVA로 transfer하여 ViT-B 기준 26.7 mAP를 얻었다.
이후 K400 label을 사용하여 supervised fine-tuning을 한 뒤 AVA로 transfer하면 31.8 mAP로 약 5 mAP 추가 향상되었다.
⇒ 게다가 추가적인 라벨을 통한 supervised learning을 하면 5maP가 오르게 된다. (26.7 → 31.8)
5.5. Comparison with the state of the art
Source: Original Document
Source: Original Document
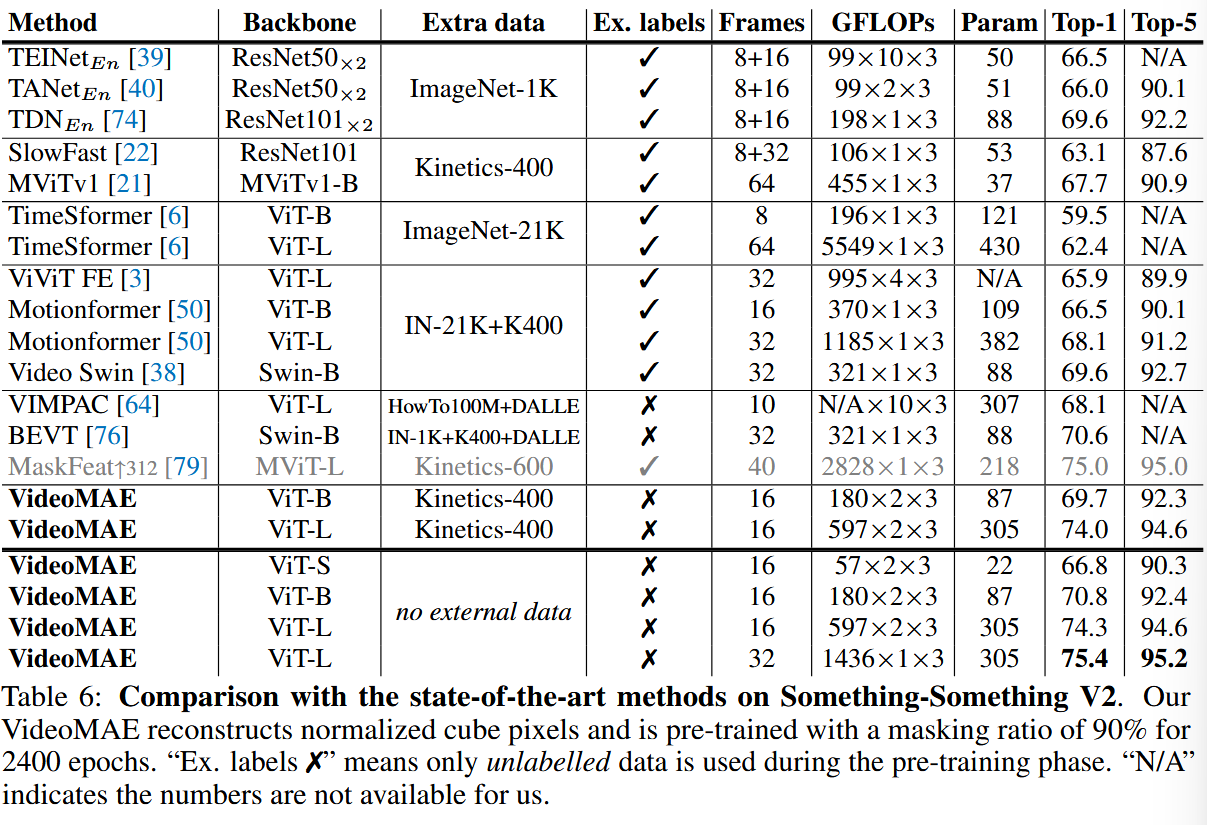
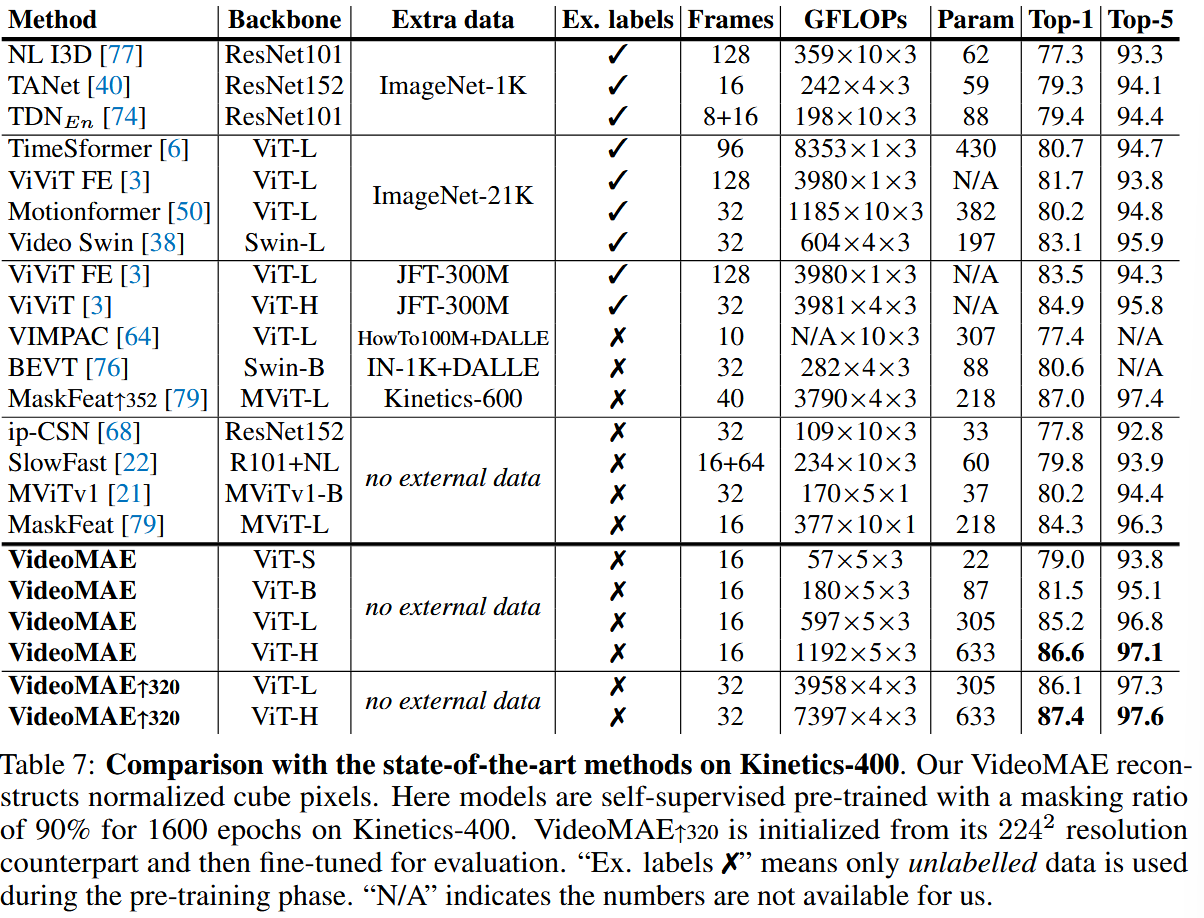
K400과 SSv2에 대해 SOTA인 모델들과도 성능을 비교해보았는데, VideoMAE는 plain ViT 기반의 단순한 구조이기 때문에, 별도의 큰 구조 변경 없이 더 큰 ViT backbone이나 더 많은 입력 프레임으로 모델 규모를 확장할 수 있었다.
Top-1, Top-5 모두 VideoMAE에서 갱신하였다. 심지어 별도의 추가적인 데이터 없이 자체적으로 학습을 진행해도 다른 SOTA와 비교할때 성능이 경쟁력이 있고 심지어 몇몇의 모델에 대해서는 더 좋은 성능이 나왔다.
6. Limitation
- Reconstruction ≠ Semantic Understanding High-ratio masked reconstruction이 high-level spatiotemporal structure 학습을 유도하지만, pixel reconstruction 자체가 object interaction이나 action semantics의 명시적 이해를 보장하지는 않는다.
- Limited Long-term Temporal Modeling 주로 16/32-frame의 짧은 clip을 대상으로 하기 때문에, 장시간에 걸친 행동 변화나 long-range temporal dependency를 모델링하는 능력은 충분히 검증되지 않았다.
- Computational Scalability High masking 덕분에 pre-training 시 joint space-time attention의 비용은 크게 감소하지만, fine-tuning/inference에서는 전체 token을 처리하므로 긴 영상이나 고해상도로 확장할 경우 quadratic attention cost가 문제가 될 수 있다.
- Limited Generality of
Data Quality > QuantityDomain-relevant한 작은 데이터가 큰 out-of-domain 데이터보다 효과적이라는 결과는 흥미롭지만, 주로 K400–SSV2 등의 특정 dataset/domain 조합에서 검증되었으므로 일반적인 원칙으로 확대하기 위해서는 추가 검증이 필요하다.